AIAITutorial NO. ---
Cara Menggunakan Gemini 4 Argon via API: Panduan Langkah demi Langkah
Dari membuat kunci API hingga menjalankan pekerjaan latar belakang hingga sejuta token, inilah cara mulai memakai model unggulan baru Google berdasarkan dokumentasi resminya, sekaligus cara menghindari tagihan yang mengejutkan.

Poin penting
- Gemini 4 Argon tersedia melalui Gemini API dengan ID model
gemini-4-argon, khusus untuk tingkat berbayar. - Anda memerlukan kunci API Google AI Studio, SDK Python
google-genai, dan sekitar sepuluh menit untuk mengirim permintaan pertama. - Secara bawaan, Argon berpikir pada tingkat "medium". Anda dapat mengatur
thinking_levelke low, medium, atau high, dan setiap token berpikir ditagih sebagai keluaran. - Untuk jawaban yang sangat panjang, "long decode" berjalan dalam mode latar belakang dan dapat menghasilkan hingga sekitar 1 juta token keluaran; tanpa fitur itu, keluaran dibatasi 65.536 token.
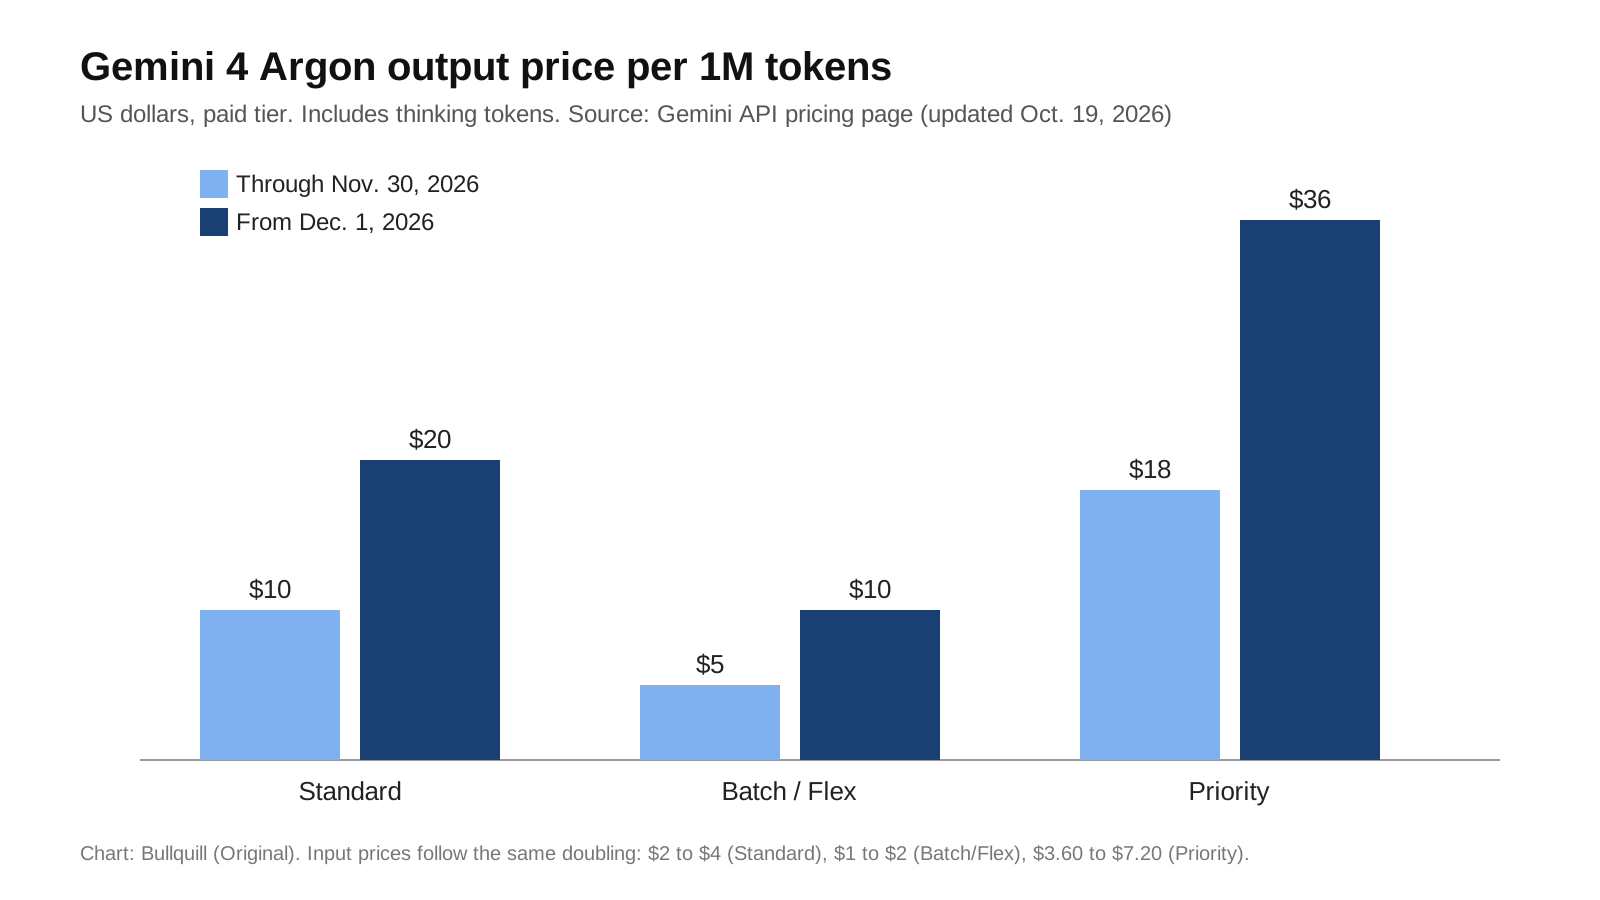
- Harga naik dua kali lipat pada 1 Desember 2026. Pekerjaan batch berharga setengahnya, dan awalan prompt yang berulang mendapat diskon cache 95%, jadi rancang untuk keduanya sejak hari pertama.
Model unggulan terbaru Google baru sedikit lebih dari sepekan berada di tangan para pengembang, dan pertanyaan di forum selalu sama: bagaimana cara mendapatkan akses, pengaturan mana yang penting, dan bagaimana menghindari tagihan yang mengejutkan? Panduan ini membahas penyiapan resmi langkah demi langkah dengan dokumentasi Google sendiri sebagai rujukan. Panduan ini mengasumsikan Anda sudah terbiasa dengan dasar-dasar Python dan terminal. Semua harga dalam dolar AS dan berasal dari halaman harga Google per 19 Oktober 2026.
Sebelum mulai: apa yang Anda perlukan
- Akun Google dan akses ke Google AI Studio.
- Proyek Google Cloud dengan penagihan (billing) aktif. Halaman harga Google mencantumkan Argon sebagai "not available" pada tingkat gratis, sehingga kunci tingkat gratis tidak akan berfungsi untuk model ini.
- Python 3 dan
pipdi komputer Anda. - Perkiraan anggaran. Bahkan eksperimen kecil dengan model penalaran dapat menghabiskan lebih banyak token daripada yang Anda duga.
Langkah 1: Buat kunci API
Dokumentasi kunci API Google menjelaskan prosesnya di AI Studio:
- Buka halaman API keys di Google AI Studio.
- Jika Anda sudah memiliki proyek Google Cloud, AI Studio tidak menampilkannya secara bawaan. Buka Dashboard, pilih Projects, lalu Import projects, pilih proyek Anda, dan impor.
- Di halaman API Keys, klik Create API key. Jika tombol itu tidak tersedia, akun Anda tidak memiliki izin yang diperlukan pada proyek tersebut; mintalah peran seperti Project Editor kepada administrator.
- Gunakan opsi "Add restrictions" untuk membatasi kunci hanya pada Gemini API.
Langkah 2: Simpan kunci dengan aman
SDK membaca kunci dari variabel lingkungan bernama GEMINI_API_KEY (atau GOOGLE_API_KEY, yang diutamakan bila keduanya diatur). Di Linux atau macOS dengan Bash, tambahkan baris ini ke ~/.bashrc lalu muat ulang shell:
export GEMINI_API_KEY="YOUR_API_KEY_HERE"Di macOS dengan Zsh, gunakan ~/.zshrc. Di Windows, tambahkan variabel lingkungan pengguna dengan nama yang sama lalu buka terminal baru. Saran keamanan Google layak diikuti sejak awal: jangan pernah meng-commit kunci ke Git, jangan pernah menyematkannya di kode peramban atau aplikasi seluler, gunakan pengelola rahasia (secret manager) di lingkungan produksi, dan atur peringatan penagihan di konsol Google Cloud. Jika kunci bocor, Google menyarankan untuk membuat dan menerapkan kunci pengganti terlebih dahulu, lalu menonaktifkan kunci lama dan meninjau log penggunaan.
Langkah 3: Pasang SDK
pip install -U google-genaiPanduan memulai cepat (quickstart) Google saat ini memakai antarmuka interactions dari SDK, dan contoh-contoh di bawah mengikutinya.
Contoh kode diadaptasi dari dokumentasi Google dan belum dijalankan oleh Bullquill; periksa rujukan SDK terkini.
Langkah 4: Kirim permintaan pertama
Simpan kode berikut sebagai first_call.py dan jalankan dengan python first_call.py:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Summarize the trade-offs between batch and real-time inference in five bullet points.",
)
print(interaction.output_text)
print(interaction.usage)
Mencetak usage pada setiap panggilan adalah kebiasaan yang baik selama Anda mempelajari model ini. Data itu menunjukkan berapa banyak token masukan, keluaran, dan berpikir yang dipakai setiap permintaan, dan itulah satu-satunya cara yang andal untuk mengetahui biaya sebenarnya dari sebuah tugas.
Langkah 5: Pilih tingkat berpikir
Argon adalah model penalaran. Menurut dokumentasi thinking Google, model ini secara bawaan berpikir pada tingkat "medium" dan menerima low, medium, atau high. Anda mengatur tingkatnya di dalam generation_config:
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Extract every date mentioned in this paragraph: ...",
    generation_config={"thinking_level": "low"},
)
Tiga aturan dari dokumentasi ini menghemat biaya dan mencegah kerepotan:
- Token berpikir ditagih sebagai keluaran, meskipun API hanya mengembalikan ringkasan penalarannya. Jumlahnya muncul di kolom usage untuk token pemikiran (thought tokens).
- Proses berpikir dihitung dalam
max_output_tokens. Jika Anda menetapkan batas rendah, model bisa kehabisan anggaran di tengah berpikir, memotong jawaban, dan tetap menagih Anda untuk proses berpikirnya. - Sesuaikan tingkat dengan tugas. Gunakan low untuk ekstraksi dan pemformatan sederhana, medium untuk sebagian besar pekerjaan pemrograman dan agen, serta high untuk penalaran yang paling sulit.
Langkah 6: Gunakan long decode untuk keluaran yang sangat panjang
Fitur andalan Argon adalah kemampuan menghasilkan keluaran yang sangat panjang, seperti pembuktian lengkap atau migrasi kode berskala besar. Panduan long decode Google menyebutkan bahwa fitur ini memerlukan eksekusi latar belakang. Tanpa itu, nilai max_output_tokens di atas 65.536 akan menghasilkan galat 400. Pola minimalnya seperti ini:
import time
from google import genai

client = genai.Client()

job = client.interactions.create(
    model="gemini-4-argon",
    input="Port this module from Python to Rust and explain each change: ...",
    background=True,
    generation_config={"max_output_tokens": 262144, "thinking_level": "high"},
)

while job.status in ("in_progress", "queued"):
    time.sleep(10)
    job = client.interactions.get(id=job.id)

print(job.status)
print(job.usage)
Ketika statusnya completed, dokumentasi menyarankan untuk menggabungkan teks dari setiap langkah model_output di job.steps, karena pekerjaan panjang menghasilkan beberapa langkah. Rincian lain dari panduan tersebut:
- Pekerjaan latar belakang memerlukan interaksi tersimpan (stored interactions) dan dapat berjalan hingga 24 jam.
- Jika Anda memakai streaming, atur batas waktu baca HTTP 15 hingga 20 menit. Setelah sekitar 64.000 token, keluaran datang dalam potongan yang lebih besar, sehingga jeda panjang adalah hal wajar.
- Google menyarankan 262.144 sebagai nilai awal untuk penalaran kompleks, dan memperingatkan agar tidak memakai batas rendah seperti 8.192.
- Model ini tidak mengikuti target jumlah kata atau token, jadi jangan meminta "tepat 50.000 kata".
- Long decode kurang cocok untuk obrolan, peringkasan, ekstraksi, dan pekerjaan yang peka terhadap latensi.
| Status pekerjaan | Artinya | Yang perlu dilakukan |
|---|---|---|
completed | Selesai | Gabungkan semua langkah model_output |
requires_action | Model memanggil sebuah alat (tool) | Jalankan alat itu dan kirimkan kembali hasilnya |
incomplete | Anggaran keluaran habis | Naikkan max_output_tokens atau turunkan thinking_level |
failed | Terjadi galat selama proses | Coba lagi; hubungi dukungan bila terulang |
cancelled | Dihentikan lebih awal | Periksa usage: pekerjaan yang sudah selesai tetap ditagih |
Sumber: Google AI for Developers, panduan long decode.
Langkah 7: Kirim pekerjaan yang tidak mendesak sebagai batch
Jika hasilnya bisa menunggu, Batch API memangkas harga hingga setengahnya. Google menargetkan waktu penyelesaian 24 jam, meskipun banyak pekerjaan selesai lebih cepat. Batch inline cocok untuk permintaan dengan total di bawah 20 MB; pekerjaan yang lebih besar memakai berkas JSONL hingga 2 GB. Dokumentasi Batch API Google menyebutkan bahwa hasilnya tetap tersedia selama enam minggu. Contoh batch dari Google memakai model Flash, tetapi halaman model Argon mencantumkan Batch sebagai fitur yang didukung:
batch = client.batches.create(
    model="gemini-4-argon",
    src=[
        {"contents": [{"role": "user", "parts": [{"text": "Classify this support ticket: ..."}]}]},
        {"contents": [{"role": "user", "parts": [{"text": "Classify this support ticket: ..."}]}]},
    ],
    config={"display_name": "ticket-triage-test"},
)
print(batch.name)
Lakukan polling dengan client.batches.get(name=batch.name) hingga statusnya JOB_STATE_SUCCEEDED, lalu baca respons inline dari kolom tujuan (destination) pekerjaan tersebut.
Langkah 8: Kendalikan biaya
| Tingkat Argon (per 1 juta token) | Masukan, s.d. 30 Nov. | Masukan, mulai 1 Des. | Keluaran, s.d. 30 Nov. | Keluaran, mulai 1 Des. |
|---|---|---|---|---|
| Standard | $2,00 | $4,00 | $10,00 | $20,00 |
| Batch / Flex | $1,00 | $2,00 | $5,00 | $10,00 |
| Priority | $3,60 | $7,20 | $18,00 | $36,00 |
| Masukan tersimpan di cache (Standard) | $0,10 | $0,20 | t/a | t/a |
Sumber: halaman harga Gemini API, terakhir diperbarui 19 Okt. 2026. Harga keluaran sudah termasuk token berpikir.
- Manfaatkan cache implisit. Argon hanya mendukung cache implisit, yang memberi diskon 95% untuk masukan berulang. Letakkan konten panjang yang stabil, seperti instruksi sistem dan dokumen rujukan, di awal prompt, dan bagian yang berubah-ubah di akhir.
- Susun anggaran dengan harga Desember. Jika sebuah beban kerja hanya masuk akal pada harga $2 dan $10, beban kerja itu tidak akan masuk akal lagi dalam enam minggu.
- Ukur sebelum memperbesar skala. Jalankan 20 hingga 50 permintaan yang representatif, catat penggunaannya, dan hitung biaya per tugas termasuk token berpikir.
- Gunakan tingkat yang tepat. Batch atau Flex untuk pekerjaan semalam; Standard untuk penggunaan interaktif; Priority hanya bila latensi penting.
- Perhatikan search grounding. Google mencantumkan 5.000 permintaan pencarian grounded gratis per bulan untuk Argon, lalu $14 per 1.000.
Kesalahan umum yang perlu dihindari
- Memakai kunci tingkat gratis. Panggilan ke Argon akan gagal sampai penagihan diaktifkan pada proyek di balik kunci tersebut.
- Menetapkan batas keluaran yang terlalu kecil. Karena proses berpikir berbagi anggaran keluaran, batas seperti 2.000 token bisa tidak menyisakan apa pun untuk jawaban pada prompt yang sulit.
- Mengaktifkan long decode untuk semua hal. Fitur ini dibuat untuk pembuktian dan tugas kode berskala besar. Untuk obrolan atau ringkasan, permintaan biasa lebih cepat dan lebih murah.
- Mengabaikan pekerjaan yang dibatalkan. Google menagih pekerjaan yang sudah diselesaikan sebelum pekerjaan latar belakang dibatalkan atau gagal, jadi periksa
usagebahkan saat Anda meninggalkan sebuah proses. - Menganggap total token masukan di semua tahap sebagai ukuran konteks. Google memperingatkan bahwa angka masukan yang dijumlahkan melebih-lebihkan seberapa banyak konteks yang benar-benar dipakai sebuah pekerjaan panjang.
Apa artinya
Bagi pengembang perorangan, harga perkenalan menjadikan saat ini momen termurah untuk menguji model terdepan pada pekerjaan nyata. Bagi tim, pelajaran yang lebih besar adalah bahwa model penalaran mengubah cara menghitung biaya: jawaban yang terlihat hanyalah sebagian dari tagihan, dan pengaturan seperti tingkat berpikir dan batas keluaran sama pentingnya dengan harga per token. Siapkan pencatatan (logging) dan batasan sebelum penerapan produksi pertama Anda, bukan setelah tagihan pertama datang.
Pertanyaan umum
Apakah Gemini 4 Argon bisa dipakai di tingkat gratis?
Tidak. Halaman harga Google mencantumkan Gemini 4 Argon sebagai tidak tersedia di tingkat gratis. Anda memerlukan proyek dengan penagihan aktif untuk memanggil gemini-4-argon melalui API.
Apa ID model untuk Gemini 4 Argon?
ID model stabilnya adalah gemini-4-argon, menurut dokumentasi pengembang Google.
Bagaimana cara mengubah tingkat berpikir Gemini 4 Argon?
Atur thinking_level di dalam generation_config ke low, medium, atau high. Nilai bawaannya medium. Token berpikir ditagih sebagai keluaran dan dihitung dalam max_output_tokens.
Bagaimana cara mendapatkan keluaran lebih dari 65.536 token?
Gunakan long decode: kirim permintaan dengan background=True dan max_output_tokens yang lebih tinggi, lalu lakukan polling pada interaksi itu hingga selesai. Tanpa mode latar belakang, nilai di atas 65.536 menghasilkan galat 400.
Bagaimana cara menekan biaya Gemini 4 Argon?
Gunakan tingkat Batch atau Flex untuk pekerjaan yang tidak mendesak dengan setengah harga, pertahankan awalan prompt yang stabil agar mendapat diskon cache implisit 95%, pilih tingkat berpikir yang lebih rendah untuk tugas sederhana, dan susun anggaran dengan harga lebih tinggi yang berlaku mulai 1 Desember 2026.
Sumber
- Google AI for Developers: Gemini 4 Argon model page
- Google AI for Developers: Gemini API quickstart
- Google AI for Developers: Using Gemini API keys
- Google AI for Developers: Thinking
- Google AI for Developers: Long decode
- Google AI for Developers: Batch API
- Google AI for Developers: Gemini API pricing
- Google: Gemini 4 Argon is now available in the Gemini app


