AIAITutorial NO. ---
Como usar o Gemini 4 Argon pela API: guia passo a passo
Da criação de uma chave de API à execução de jobs em segundo plano de um milhão de tokens: veja como começar a usar o novo modelo carro-chefe do Google, com base na documentação oficial, e como evitar uma conta surpresa.

Principais pontos
- O Gemini 4 Argon está disponível pela API do Gemini com o ID de modelo
gemini-4-argon, somente no nível pago. - Você precisa de uma chave de API do Google AI Studio, do SDK para Python
google-genaie de cerca de dez minutos para enviar a primeira solicitação. - Por padrão, o Argon raciocina no nível "medium". Você pode definir
thinking_levelcomo low, medium ou high, e cada token de raciocínio é cobrado como saída. - Para respostas muito longas, a "decodificação longa" (long decode) roda em modo de segundo plano e pode retornar até cerca de 1 milhão de tokens de saída; sem ela, a saída fica limitada a 65.536 tokens.
- Os preços dobram em 1º de dezembro de 2026. Jobs em lote custam metade, e prefixos de prompt repetidos recebem desconto de cache de 95%, então planeje para os dois desde o primeiro dia.
O novo modelo carro-chefe do Google está nas mãos dos desenvolvedores há pouco mais de uma semana, e as perguntas nos fóruns são sempre as mesmas: como consigo acesso, quais configurações importam e como evito uma conta surpresa? Este guia percorre a configuração oficial passo a passo, usando a própria documentação do Google como referência. Ele pressupõe familiaridade básica com Python e com o terminal. Todos os preços estão em dólares americanos e vêm da página de preços do Google em 19 de outubro de 2026.
Antes de começar: o que você precisa
- Uma conta do Google e acesso ao Google AI Studio.
- Um projeto do Google Cloud com faturamento ativado. A página de preços do Google lista o Argon como "não disponível" no nível gratuito, então chaves desse nível não funcionarão com este modelo.
- Python 3 e
pipinstalados na sua máquina. - Um orçamento aproximado. Até pequenos experimentos com um modelo de raciocínio podem consumir mais tokens do que você imagina.
Passo 1: Crie uma chave de API
A documentação de chaves de API do Google descreve o processo no AI Studio:
- Abra a página de chaves de API (API keys) no Google AI Studio.
- Se você já tem um projeto do Google Cloud, o AI Studio não o exibe por padrão. Vá ao Dashboard, escolha Projects, depois Import projects, selecione seu projeto e importe-o.
- Na página API Keys, clique em Create API key. Se o botão não estiver disponível, sua conta não tem as permissões necessárias nesse projeto; peça a um administrador um papel como Project Editor.
- Use a opção "Add restrictions" para limitar a chave à API do Gemini.
Passo 2: Guarde a chave com segurança
O SDK lê a chave de uma variável de ambiente chamada GEMINI_API_KEY (ou GOOGLE_API_KEY, que tem prioridade se as duas estiverem definidas). No Linux ou no macOS com Bash, adicione esta linha ao ~/.bashrc e recarregue o shell:
export GEMINI_API_KEY="YOUR_API_KEY_HERE"No macOS com Zsh, use ~/.zshrc. No Windows, adicione uma variável de ambiente de usuário com o mesmo nome e abra um novo terminal. Vale seguir as recomendações de segurança do Google desde o início: nunca faça commit de chaves no Git, nunca as incorpore em código de navegador ou de aplicativos móveis, use um gerenciador de segredos em produção e configure alertas de faturamento no console do Google Cloud. Se uma chave vazar, o Google recomenda criar e implantar primeiro uma chave substituta, depois desativar a antiga e revisar os registros de uso.
Passo 3: Instale o SDK
pip install -U google-genaiO guia de início rápido atual do Google usa a interface interactions do SDK, que é a seguida pelos exemplos abaixo.
Os exemplos de código foram adaptados da documentação do Google e não foram executados pelo Bullquill; confira a referência atual do SDK.
Passo 4: Envie sua primeira solicitação
Salve o código a seguir como first_call.py e execute-o com python first_call.py:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Summarize the trade-offs between batch and real-time inference in five bullet points.",
)
print(interaction.output_text)
print(interaction.usage)
Imprimir usage em cada chamada é um bom hábito enquanto você aprende a usar o modelo. Ele mostra quantos tokens de entrada, de saída e de raciocínio cada solicitação consumiu, e é a única forma confiável de saber quanto uma tarefa realmente custa.
Passo 5: Escolha um nível de raciocínio
O Argon é um modelo de raciocínio. Segundo a documentação de raciocínio (thinking) do Google, ele raciocina por padrão no nível "medium" e aceita low, medium ou high. Você define o nível dentro de generation_config:
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Extract every date mentioned in this paragraph: ...",
    generation_config={"thinking_level": "low"},
)
Três regras da documentação economizam dinheiro e dor de cabeça:
- Tokens de raciocínio são cobrados como saída, mesmo que a API retorne apenas um resumo do raciocínio. A contagem aparece no campo usage referente aos tokens de pensamento (thought tokens).
- O raciocínio conta para
max_output_tokens. Se você definir um limite baixo, o modelo pode esgotar o orçamento no meio do raciocínio, cortar a resposta e ainda cobrar pelo raciocínio. - Ajuste o nível à tarefa. Use low para extração e formatação simples, medium para a maior parte do trabalho de programação e de agentes, e high para o raciocínio mais difícil.
Passo 6: Use a decodificação longa para saídas muito extensas
O recurso de destaque do Argon é a capacidade de produzir saídas extremamente longas, como uma prova completa ou uma grande migração de código. O guia de decodificação longa do Google diz que isso exige execução em segundo plano. Sem ela, qualquer valor de max_output_tokens acima de 65.536 retorna um erro 400. Um padrão mínimo é este:
import time
from google import genai

client = genai.Client()

job = client.interactions.create(
    model="gemini-4-argon",
    input="Port this module from Python to Rust and explain each change: ...",
    background=True,
    generation_config={"max_output_tokens": 262144, "thinking_level": "high"},
)

while job.status in ("in_progress", "queued"):
    time.sleep(10)
    job = client.interactions.get(id=job.id)

print(job.status)
print(job.usage)
Quando o status for completed, a documentação orienta a juntar o texto de cada etapa model_output em job.steps, porque um job longo produz várias. Outros detalhes do guia:
- Jobs em segundo plano exigem interações armazenadas e podem rodar por até 24 horas.
- Se você usar streaming, defina tempos limite de leitura HTTP de 15 a 20 minutos. Depois de cerca de 64.000 tokens, a saída chega em blocos maiores, então pausas longas são normais.
- O Google sugere 262.144 como valor inicial para raciocínio complexo e desaconselha limites baixos como 8.192.
- O modelo não segue metas de palavras ou de tokens, então não peça "exatamente 50.000 palavras".
- A decodificação longa não é indicada para chat, resumos, extração e trabalhos sensíveis à latência.
| Status do job | O que significa | O que fazer |
|---|---|---|
completed | Concluído | Juntar todas as etapas model_output |
requires_action | O modelo chamou uma ferramenta | Executar a ferramenta e enviar o resultado de volta |
incomplete | O orçamento de saída acabou | Aumentar max_output_tokens ou reduzir thinking_level |
failed | Erro durante a execução | Tentar de novo; acionar o suporte se o erro se repetir |
cancelled | Interrompido antes do fim | Verificar usage: o trabalho concluído continua sendo cobrado |
Fonte: Google AI for Developers, guia de decodificação longa.
Passo 7: Envie trabalho não urgente em lote
Se os resultados podem esperar, a Batch API corta o preço pela metade. O Google tem como meta um prazo de 24 horas, embora muitos jobs terminem antes. Lotes inline servem para solicitações com menos de 20 MB no total; jobs maiores usam um arquivo JSONL de até 2 GB. A documentação da Batch API do Google informa que os resultados ficam disponíveis por seis semanas. O exemplo de lote do Google usa um modelo Flash, mas a página do modelo Argon lista Batch como compatível:
batch = client.batches.create(
    model="gemini-4-argon",
    src=[
        {"contents": [{"role": "user", "parts": [{"text": "Classify this support ticket: ..."}]}]},
        {"contents": [{"role": "user", "parts": [{"text": "Classify this support ticket: ..."}]}]},
    ],
    config={"display_name": "ticket-triage-test"},
)
print(batch.name)
Consulte periodicamente com client.batches.get(name=batch.name) até que o estado seja JOB_STATE_SUCCEEDED e então leia as respostas inline no campo de destino do job.
Passo 8: Mantenha os custos sob controle
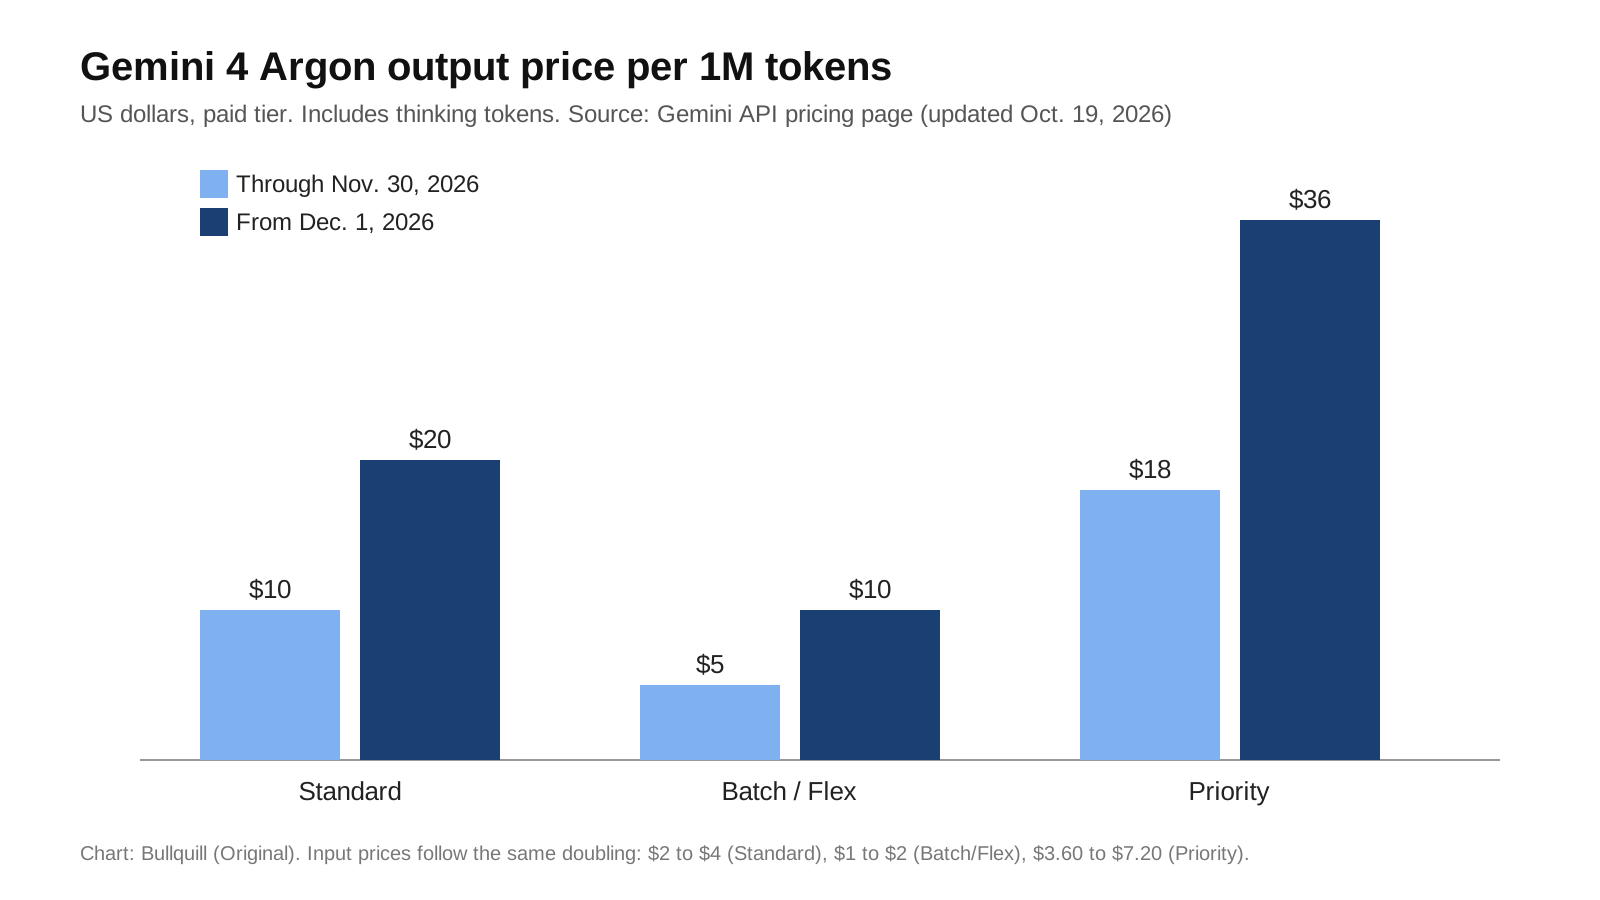
| Nível do Argon (por 1 milhão de tokens) | Entrada, até 30 nov. | Entrada, a partir de 1º dez. | Saída, até 30 nov. | Saída, a partir de 1º dez. |
|---|---|---|---|---|
| Standard | US$ 2,00 | US$ 4,00 | US$ 10,00 | US$ 20,00 |
| Batch / Flex | US$ 1,00 | US$ 2,00 | US$ 5,00 | US$ 10,00 |
| Priority | US$ 3,60 | US$ 7,20 | US$ 18,00 | US$ 36,00 |
| Entrada em cache (Standard) | US$ 0,10 | US$ 0,20 | n/d | n/d |
Fonte: página de preços da API do Gemini, atualizada em 19 out. 2026. Os preços de saída incluem os tokens de raciocínio.
- Aproveite o cache implícito. O Argon só oferece cache implícito, que dá 95% de desconto na entrada repetida. Coloque o conteúdo longo e estável, como instruções de sistema e documentos de referência, no início do prompt, e a parte variável no fim.
- Faça o orçamento com os preços de dezembro. Se uma carga de trabalho só faz sentido a US$ 2 e US$ 10, ela deixará de fazer sentido em seis semanas.
- Meça antes de escalar. Rode de 20 a 50 solicitações representativas, registre o uso e calcule o custo por tarefa, incluindo os tokens de raciocínio.
- Use o nível certo. Batch ou Flex para jobs noturnos; Standard para uso interativo; Priority só quando a latência importar.
- Fique de olho no grounding com pesquisa. O Google lista 5.000 solicitações de pesquisa com grounding gratuitas por mês no Argon e, depois disso, US$ 14 a cada 1.000.
Erros comuns a evitar
- Usar uma chave do nível gratuito. As chamadas ao Argon vão falhar até que o faturamento seja ativado no projeto vinculado à chave.
- Definir um limite de saída minúsculo. Como o raciocínio divide o orçamento de saída, um limite como 2.000 tokens pode não deixar nada para a resposta em um prompt difícil.
- Ativar a decodificação longa para tudo. Ela foi feita para provas e grandes tarefas de código. Para chat ou resumos, uma solicitação normal é mais rápida e mais barata.
- Ignorar jobs cancelados. O Google cobra o trabalho concluído antes de um job em segundo plano ser cancelado ou falhar, então verifique
usagemesmo quando abandonar uma execução. - Tratar o total de tokens de entrada de todas as etapas como tamanho do contexto. O Google alerta que a soma da entrada superestima quanto contexto um job longo está de fato usando.
O que significa
Para desenvolvedores individuais, o preço de lançamento faz deste o momento mais barato para avaliar um modelo de ponta em trabalho real. Para equipes, a lição maior é que modelos de raciocínio mudam o cálculo de custos: a resposta visível é só parte da conta, e configurações como nível de raciocínio e limites de saída importam tanto quanto o preço por token. Monte o registro de uso e os limites antes da primeira implantação em produção, não depois da primeira fatura.
Perguntas frequentes
Posso usar o Gemini 4 Argon no nível gratuito?
Não. A página de preços do Google lista o Gemini 4 Argon como não disponível no nível gratuito. Você precisa de um projeto com faturamento ativado para chamar o gemini-4-argon pela API.
Qual é o ID de modelo do Gemini 4 Argon?
O ID de modelo estável é gemini-4-argon, segundo a documentação para desenvolvedores do Google.
Como mudo o nível de raciocínio do Gemini 4 Argon?
Defina thinking_level dentro de generation_config como low, medium ou high. O padrão é medium. Os tokens de raciocínio são cobrados como saída e contam para max_output_tokens.
Como obter saídas com mais de 65.536 tokens?
Use a decodificação longa (long decode): envie a solicitação com background=True e um max_output_tokens maior e consulte a interação até que ela termine. Sem o modo em segundo plano, valores acima de 65.536 retornam um erro 400.
Como reduzir os custos do Gemini 4 Argon?
Use os níveis Batch ou Flex para trabalho não urgente pela metade do preço, mantenha um prefixo de prompt estável para aproveitar o desconto de 95% do cache implícito, escolha níveis de raciocínio mais baixos para tarefas simples e faça o orçamento com os preços mais altos que valem a partir de 1º de dezembro de 2026.
Fontes
- Google AI for Developers: Gemini 4 Argon model page
- Google AI for Developers: Gemini API quickstart
- Google AI for Developers: Using Gemini API keys
- Google AI for Developers: Thinking
- Google AI for Developers: Long decode
- Google AI for Developers: Batch API
- Google AI for Developers: Gemini API pricing
- Google: Gemini 4 Argon is now available in the Gemini app


