AIAIExplainer NO. ---
Gemini 4 Argon vs GPT-6 Astra e Claude Opus 5.5: os números
O novo modelo principal do Google lidera a maioria das linhas da sua própria tabela de benchmarks e custa menos que os rivais até 30 de novembro. Veja o que dizem os números oficiais, onde os fornecedores discordam e quanto ele custa na prática.

Principais pontos
- O Google anunciou o Gemini 4 Argon em 30 de setembro de 2026 e o liberou para assinantes do Google AI Pro e Ultra e para clientes pagos da API em 13 de outubro. O ID do modelo na API é
gemini-4-argon. - Na tabela comparativa do próprio Google, o Argon registra a maior pontuação na maioria das linhas diante do GPT-6 Astra, da OpenAI, e do Claude Opus 5.5 e do Fable 5.1, da Anthropic, mas fica atrás no Terminal-bench 4.0, FrontierSWE v2, Terminal-Bench Science, PostTrainBench e OSWorld-2.0.
- O preço é a arma mais afiada. O Argon custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída até 30 de novembro de 2026; depois, US$ 4 e US$ 20. O preço de tabela do GPT-6 Astra é de US$ 10 e US$ 50; o do Opus 5.5, de US$ 4 e US$ 20.
- O Argon tem uma janela de contexto de 1.048.576 tokens compartilhada entre entrada e saída, além de um modo de "decodificação longa" (long decode) que pode gerar até cerca de 1 milhão de tokens de saída em uma única tarefa em segundo plano.
- Todos os principais números de benchmark aqui são autodeclarados pelas empresas, e as tabelas dos fornecedores divergem entre si para os mesmos modelos. Trate-os como indicativos.
Três semanas depois de o Google apresentá-lo, e uma semana depois de ele chegar aos usuários pagantes, o Gemini 4 Argon é o modelo de IA com o qual o restante do setor está sendo comparado. Ele chega em um segundo semestre movimentado: a OpenAI lançou o GPT-6 Astra no início de setembro, e a Anthropic lançou o Claude Opus 5.5 em 22 de setembro. Cada empresa reivindica a liderança em algum conjunto de testes. Este texto coloca os números oficiais lado a lado, explica onde eles se contradizem e mostra o que os preços significam na prática.
O que o Google lançou, e quando
O anúncio do Google DeepMind, publicado em 30 de setembro e assinado por Koray Kavukcuoglu, seu arquiteto-chefe de IA, descreveu um lançamento em fases. O Argon foi primeiro para um grupo verificado de defensores cibernéticos por meio do que o Google chama de Fairwind Program, e o Google disse que essa versão foi liberada sem as proteções cibernéticas habituais para esses usuários de confiança e para equipes internas. O Google também afirmou participar do processo voluntário de acesso pré-lançamento do governo dos Estados Unidos. Nas palavras da empresa, "Safely releasing frontier capabilities at this level requires a phased approach" (lançar com segurança capacidades de fronteira neste nível exige uma abordagem em fases).
O acesso amplo veio em 13 de outubro. O blog de produtos do Google informou que assinantes Pro e Ultra poderiam usar o Argon no app Gemini, junto com um novo recurso, o Tasks, que permite ao Gemini continuar trabalhando em apps conectados, e uma interface de programação agêntica do Google Antigravity dentro do app Gemini para macOS. Desenvolvedores podem acessá-lo pela API do Gemini e pelo Google AI Studio no nível pago; a página de preços do Google diz que o Argon não está disponível no nível gratuito.
A publicação de lançamento do Google apostou tanto em demonstrações práticas quanto em pontuações. Segundo a empresa, uma versão em Rust do decodificador de vídeo libgav1, reescrita por agentes do Argon, decodifica vídeo 2,7 vezes mais rápido que a versão original, e agentes do Argon trabalhando em um projeto interno de eficiência de memória identificaram otimizações que devem liberar mais de 300 TiB. Esses são resultados internos do Google e não foram reproduzidos de forma independente.
As especificações lado a lado
| Item | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Lançamento | Anunciado em 30 set.; acesso amplo em 13 out. 2026 | Início de setembro de 2026 | 22 set. 2026 |
| Preço de entrada (por 1M de tokens) | US$ 2,00 até 30 nov., depois US$ 4,00 | US$ 10,00 | US$ 4,00 |
| Preço de saída (por 1M de tokens) | US$ 10,00 até 30 nov., depois US$ 20,00 | US$ 50,00 | US$ 20,00 |
| Entrada em cache (por 1M de tokens) | US$ 0,10, depois US$ 0,20 (apenas cache implícito) | US$ 1,00 | US$ 0,20 (leitura de cache); US$ 5 gravação de cache |
| Janela de contexto | 1.048.576 tokens, compartilhada com a saída | 1.050.000 tokens | Não informada por modelo na página de preços ("até 1M") |
| Saída máxima | 65.536 por padrão; até 1.048.576 com long decode | 128.000 tokens | Não informada nas fontes consultadas |
| Data de corte do conhecimento | Não informada | 30 de abril de 2026 | Não informada nas fontes consultadas |
| Entradas | Texto, imagem, vídeo, áudio, PDF | Ver documentação da OpenAI | Ver documentação da Anthropic |
Fontes: páginas de modelo e de preços do Google AI for Developers (atualizadas pela última vez em 14 e 19 de outubro de 2026); documentação para desenvolvedores da OpenAI sobre o GPT-6 Astra; anúncio do Opus 5.5 da Anthropic e página de preços do Claude. Preços do nível padrão, em dólares americanos.
Dois detalhes passam facilmente despercebidos. Primeiro, o "contexto de 1M" do Argon é um único orçamento compartilhado entre entrada e saída, de modo que um prompt muito longo deixa menos espaço para a resposta. Segundo, o preço promocional do Google é temporário: a partir de 1º de dezembro, o Argon custa o mesmo por token que o Opus 5.5. O processamento Batch e Flex do Argon custa metade da tarifa padrão, e o Priority custa mais.
A tabela de benchmarks e suas ressalvas
A página do modelo do Google compara o Argon com o GPT-6 Astra, o Claude Fable 5.1 e o Claude Opus 5.5 em 19 linhas, agrupadas em oito áreas: trabalho do conhecimento, programação agêntica, engenharia de aprendizado de máquina, ciência e matemática, contexto longo, uso de computador, compreensão multimodal e cibersegurança. A seleção abaixo cobre a maioria dessas áreas. Todos os números são do Google.
| Benchmark (tabela do Google) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index (trabalho do conhecimento) | 68,9% | 63,1% | 65,8% | 67,0% |
| AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% |
| DeepSWE v1.1 (programação agêntica) | 77,9% | 74,1% | 67,4% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% |
| GraphWalks BFS, de 256k a 1M (F1) | 84,2% | 71,8% | 65,0% | 66,8% |
| LVBench (compreensão de vídeo) | 91,7% | 87,5% | 79,7% | 83,7% |
| Agent's Last Exam (uso de computador) | 39,5% | 34,2% | n/d | 38,2% |
| CWE-bench v1 (cibersegurança) | 68,0% | 68,0% | 58,0% | 67,0% |
Fonte: Google DeepMind, página do modelo Gemini, resultados autodeclarados. O negrito marca a maior pontuação de cada linha.
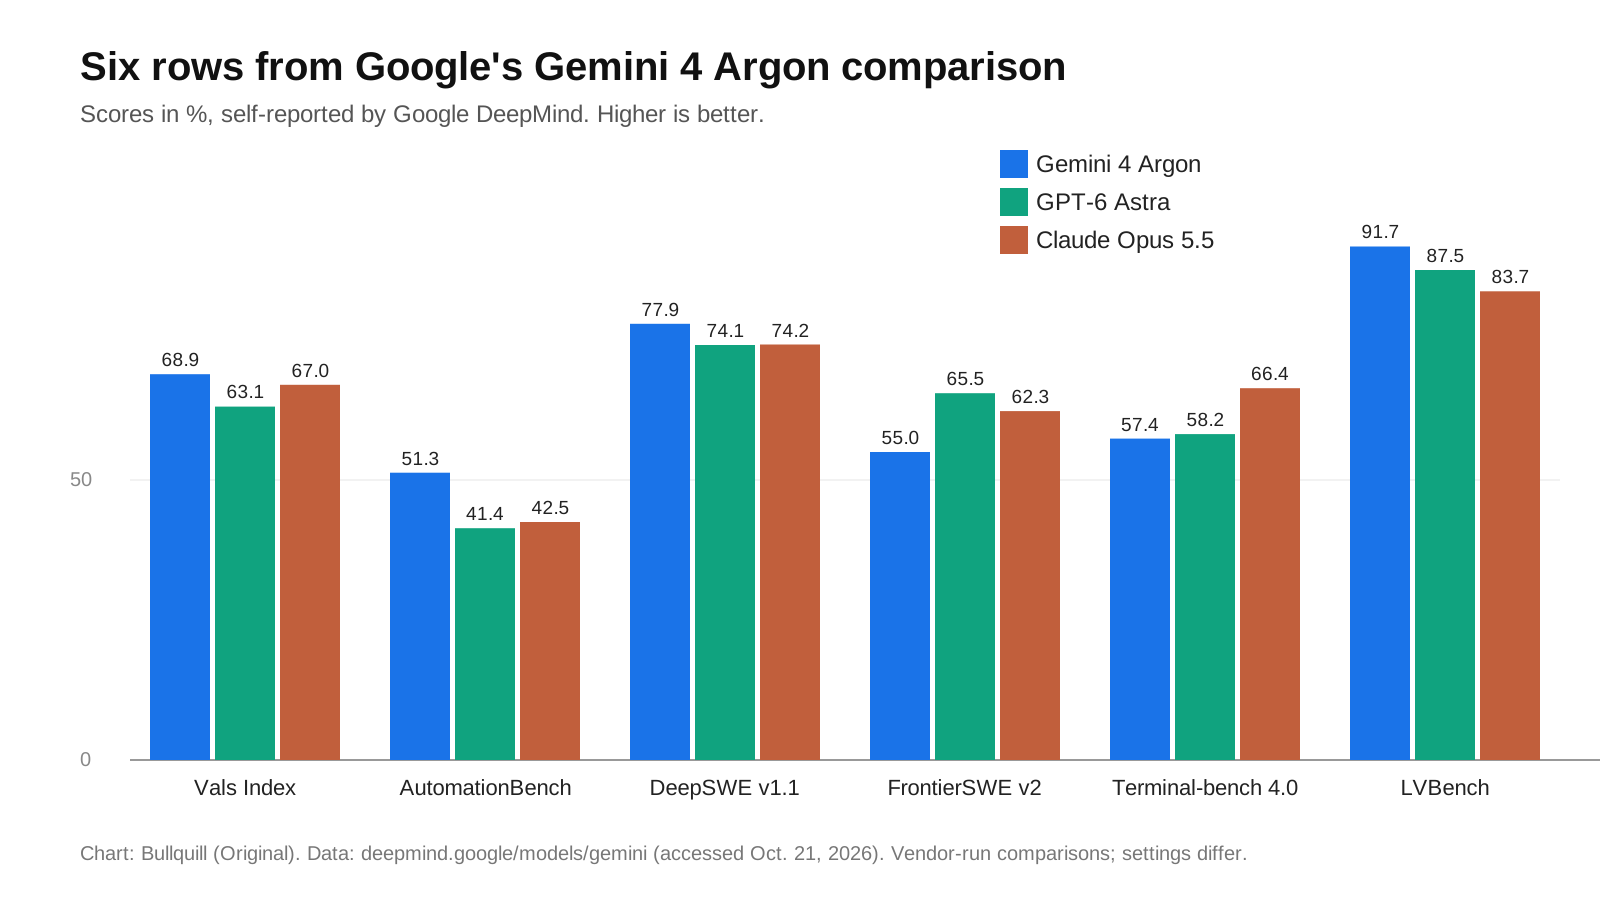
O padrão é bem claro: o Argon é mais forte em automação do trabalho do conhecimento, recuperação de informações em contexto longo e compreensão de vídeo, e é competitivo, mas não dominante, em programação agêntica. O Opus 5.5, da Anthropic, lidera no Terminal-bench 4.0, e o Astra, da OpenAI, lidera no FrontierSWE v2 e no teste de terminal científico. A maior diferença isolada está na recuperação em contexto longo entre 256.000 e 1 milhão de tokens, em que os 84,2% do Argon ficam mais de 12 pontos à frente do modelo seguinte na tabela do Google.
A pergunta mais difícil é quanto confiar em uma única tabela. Quando as empresas testam modelos rivais por conta própria, elas escolhem as configurações, o acesso a ferramentas e o nível de esforço. Assim, o mesmo benchmark pode gerar números diferentes para o mesmo modelo, dependendo de quem o executou:
| Modelo e benchmark | Tabela do Google | Anúncio da Anthropic |
|---|---|---|
| Opus 5.5 no AutomationBench | 42,5% | 40,0% |
| Opus 5.5 no Terminal-Bench Science 0.1 | 63,3% | 58,7% |
| GPT-6 Astra no Terminal-Bench Science 0.1 | 68,1% | 64,6% |
| GPT-6 Astra no Terminal-bench 4.0 | 58,2% | 57,9% |
A própria Anthropic observa que algumas de suas pontuações foram informadas com níveis de esforço diferentes. Rankings independentes ajudam, mas não resolvem a questão. A Vals.ai, que mantém o Vals Index, colocou o Argon com 68,90% e em primeiro lugar entre 41 modelos em uma atualização de 30 de setembro, enquanto sua página do modelo mostrou depois uma pontuação e uma posição ligeiramente diferentes, um exemplo de como esses rankings mudam rápido à medida que modelos e conjuntos de testes são atualizados. A Vals também informou que o Argon custou menos por teste que o Opus 5.5 em seu índice.
O que os preços representam na prática
Preços por token ficam mais fáceis de comparar com um exemplo. Considere uma solicitação com 100.000 tokens de entrada e 10.000 tokens de saída, típica da revisão de um documento grande, sem considerar o cache:
| Modelo | Custo de entrada | Custo de saída | Total por solicitação |
|---|---|---|---|
| Gemini 4 Argon (até 30 nov.) | US$ 0,20 | US$ 0,10 | US$ 0,30 |
| Gemini 4 Argon (a partir de 1º dez.) | US$ 0,40 | US$ 0,20 | US$ 0,60 |
| Claude Opus 5.5 | US$ 0,40 | US$ 0,20 | US$ 0,60 |
| GPT-6 Astra | US$ 1,00 | US$ 0,50 | US$ 1,50 |
Cálculo da Bullquill com base nos preços de tabela. As contas reais dependem de cache, descontos de batch e, principalmente, dos tokens de raciocínio.
Esse último ponto é importante. A documentação do Google diz que os tokens de raciocínio (thinking) do Argon são cobrados como saída, embora a API retorne apenas um resumo do raciocínio, e que o nível de raciocínio padrão é "medium". Assim, um problema difícil pode gerar muito mais saída cobrável do que a resposta visível sugere. A mesma lógica vale, de formas diferentes, para os outros modelos de raciocínio: o anúncio do Opus 5.5 da Anthropic diz que o raciocínio não pode mais ser desligado nesse modelo.
Outros destaques da semana
O Google não foi o único laboratório a lançar novidades. A DeepSeek publicou uma atualização menor, o DeepSeek-V4.1-Flash-1017, no Hugging Face sob a licença MIT, com contexto de 1 milhão de tokens e ganhos em benchmarks em relação à versão Flash anterior, e divulgou um framework de inferência de código aberto chamado DeepInfer, que chamou muita atenção no Hacker News. Na tabela publicada pela própria DeepSeek, o modelo de pesos abertos ainda fica atrás do Opus 5, modelo mais antigo da Anthropic, em testes como o Humanity's Last Exam sem ferramentas, mas o supera por pouco no DeepSWE v1.1, sinal de que a diferença em programação agêntica está diminuindo.
O que significa
Para desenvolvedores. O Argon é o mais barato dos três modelos principais até 30 de novembro. Equipes que quiserem testá-lo pelo preço menor têm cerca de seis semanas. Quem for construir sobre ele deve fazer o orçamento com o preço de dezembro e definir os níveis de raciocínio de forma deliberada.
Para empresas. As especificações estão convergindo: os três modelos agora oferecem janelas de contexto de cerca de 1 milhão de tokens e preços na mesma faixa, exceto pelo valor mais alto do Astra. A decisão depende cada vez mais de qual modelo se sai melhor na sua própria carga de trabalho, além do tratamento de dados e da disponibilidade regional, e não das pontuações de destaque.
Para o mercado. O preço promocional do Google pressiona o preço de tabela mais alto da OpenAI. Segundo o anúncio do Opus 5.5 da Anthropic, a empresa reduziu o preço do Opus com a versão 5.5, de US$ 5 e US$ 25 para US$ 4 e US$ 20. A tendência é de preços menores para um mesmo nível de capacidade.
Para a política de segurança. O lançamento escalonado do Google, com uma versão sem proteções para defensores cibernéticos verificados e a participação em um processo de pré-lançamento do governo dos Estados Unidos, mostra como os laboratórios estão lidando agora com os modelos mais capazes: acesso limitado primeiro, lançamento amplo depois.
Perguntas frequentes
Quando o Gemini 4 Argon foi lançado?
O Google o anunciou em 30 de setembro de 2026, inicialmente para defensores cibernéticos verificados. O acesso amplo para assinantes do Google AI Pro e Ultra e para clientes pagos da API começou em 13 de outubro de 2026.
Quanto custa a API do Gemini 4 Argon?
No nível pago padrão, US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída até 30 de novembro de 2026; depois, US$ 4 e US$ 20 a partir de 1º de dezembro. A entrada em cache custa US$ 0,10 e sobe para US$ 0,20. Batch e Flex custam metade. O modelo não está disponível no nível gratuito.
Qual é a janela de contexto do Gemini 4 Argon?
1.048.576 tokens, compartilhados entre entrada e saída. A saída padrão é limitada a 65.536 tokens; a decodificação longa (long decode) no modo em segundo plano permite até cerca de 1 milhão de tokens de saída.
O Gemini 4 Argon é melhor que o GPT-6 Astra e o Claude Opus 5.5?
Na tabela do próprio Google, ele lidera a maioria das linhas, mas o GPT-6 Astra lidera no FrontierSWE v2 e no Terminal-Bench Science, e o Opus 5.5 lidera no Terminal-bench 4.0. Os resultados divulgados por cada fornecedor diferem para os mesmos modelos, então teste com a sua própria carga de trabalho.
Os tokens de raciocínio são cobrados?
Sim. A documentação do Google diz que os tokens de raciocínio (thinking) do Argon são cobrados como tokens de saída, embora a API retorne apenas um resumo do raciocínio.
Fontes
- Google: Gemini 4 Argon, our next era of frontier intelligence (30 set. 2026)
- Google: Gemini 4 Argon is now available in the Gemini app (13 out. 2026)
- Google DeepMind: página do modelo Gemini e tabela de benchmarks
- Google AI for Developers: página do modelo Gemini 4 Argon
- Google AI for Developers: preços da API do Gemini
- Documentação para desenvolvedores da OpenAI: GPT-6 Astra
- Anthropic: anúncio do Claude Opus 5.5
- Anthropic: preços do Claude
- Vals.ai: resultados do Gemini 4 Argon
- Hugging Face: ficha do modelo DeepSeek-V4.1-Flash-1017


