AIAITutorial NO. ---
Gemini 4 Argon を API で使う方法:ステップごとの導入ガイド
API キーの作成から100万トークン規模のバックグラウンドジョブの実行まで、Google の新しいフラッグシップモデルの使い方を公式ドキュメントに基づいて解説します。想定外の請求を避ける方法も紹介します。

要点
- Gemini 4 Argon は、モデル ID
gemini-4-argonで Gemini API から利用できます。利用できるのは有料枠のみです。 - 最初のリクエストを送るには、Google AI Studio の API キー、Python 用 SDK
google-genai、そして10分ほどの時間があれば十分です。 - Argon はデフォルトで「medium」レベルの思考(thinking)を行います。
thinking_levelは low、medium、high から設定でき、思考トークンはすべて出力として課金されます。 - 非常に長い回答には「ロングデコード(long decode)」をバックグラウンドモードで使い、最大で約100万出力トークンを得られます。使わない場合、出力の上限は65,536トークンです。
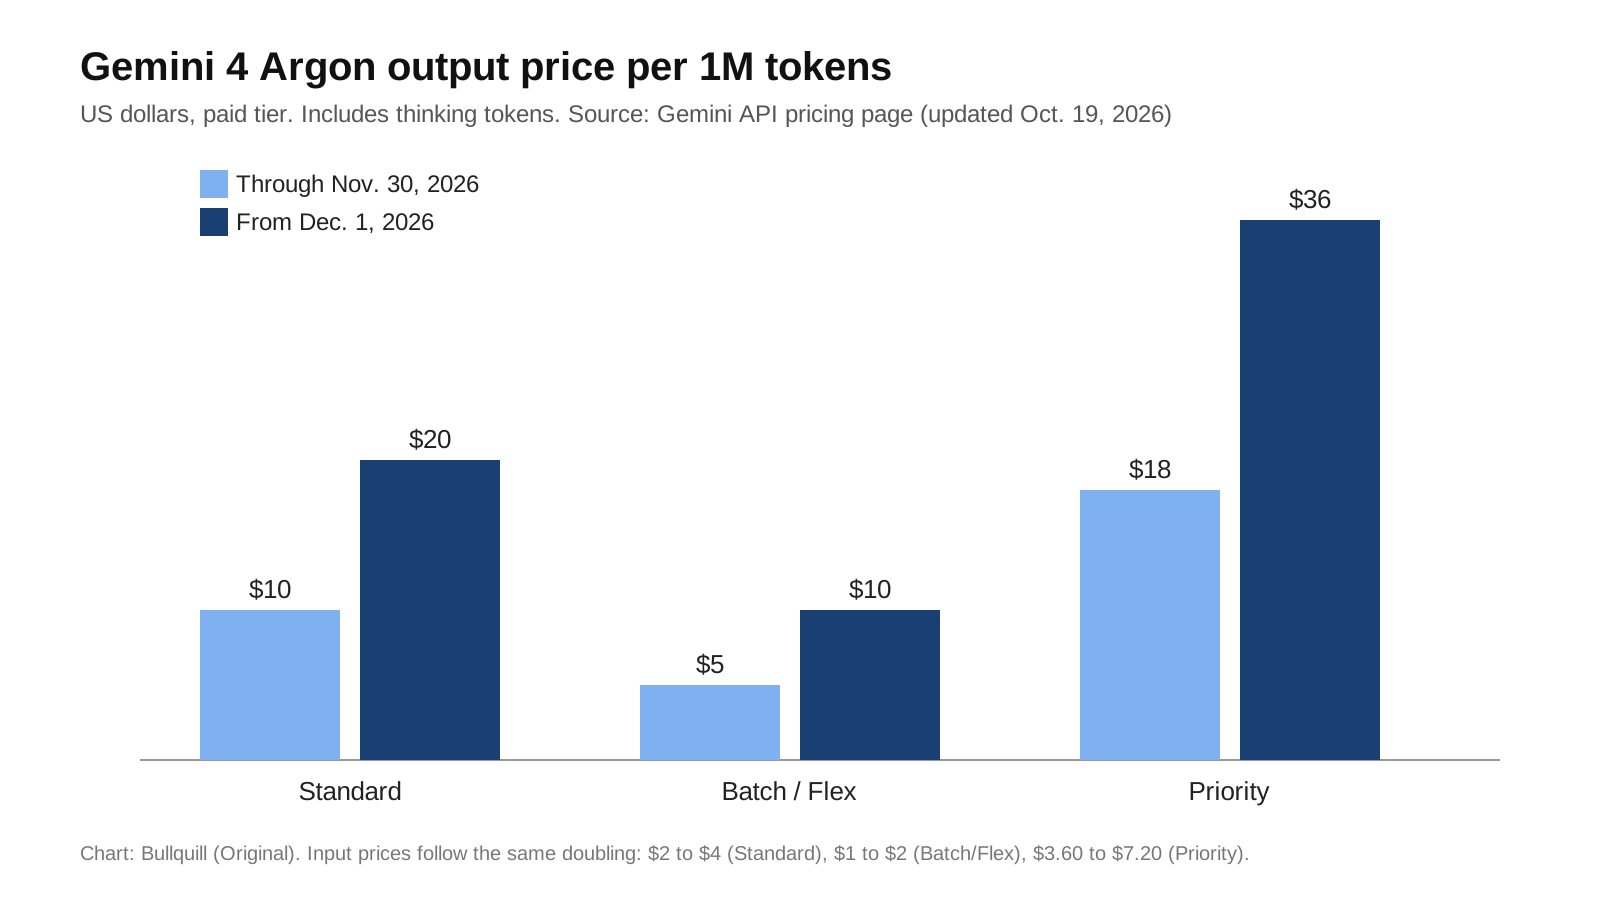
- 料金は2026年12月1日に2倍になります。バッチ処理は半額で、繰り返し使うプロンプトの先頭部分には95%のキャッシュ割引が適用されるため、初日から両方を前提に設計しましょう。
Google の最新フラッグシップモデルが開発者の手に渡ってから1週間余りが経ちましたが、フォーラムで寄せられる質問はいつも同じです。どうすれば使えるのか、どの設定が重要なのか、そして想定外の請求をどう避けるのか、という点です。本ガイドでは、Google 自身のドキュメントを参照しながら、公式のセットアップ手順を一つずつ説明します。Python とターミナルの基本的な操作に慣れていることを前提としています。料金はすべて米ドル建てで、2026年10月19日時点の Google の料金ページに基づいています。
始める前に:必要なもの
- Google アカウントと Google AI Studio へのアクセス。
- 課金を有効にした Google Cloud プロジェクト。Google の料金ページでは、Argon は無料枠で「not available(利用不可)」とされているため、無料枠のキーではこのモデルを使えません。
- お使いのマシンにインストールされた Python 3 と
pip。 - おおよその予算。推論モデルでは、小さな実験でも予想以上にトークンを消費することがあります。
ステップ1:API キーを作成する
Google の API キーに関するドキュメントでは、AI Studio での手順が次のように説明されています。
- Google AI Studio の API キー(API keys)ページを開きます。
- 既存の Google Cloud プロジェクトがある場合でも、AI Studio にはデフォルトで表示されません。Dashboard から Projects を選び、Import projects でプロジェクトを選択してインポートします。
- API Keys ページで Create API key をクリックします。ボタンが使えない場合は、そのプロジェクトに対するアカウントの権限が不足しています。管理者に Project Editor などのロールを付与してもらってください。
- 「Add restrictions」オプションを使い、キーを Gemini API のみに制限します。
ステップ2:キーを安全に保管する
SDK は、GEMINI_API_KEY という名前の環境変数からキーを読み込みます(GOOGLE_API_KEY も使え、両方が設定されている場合はこちらが優先されます)。Linux または macOS で Bash を使っている場合は、次の行を ~/.bashrc に追加し、シェルを再読み込みします。
export GEMINI_API_KEY="YOUR_API_KEY_HERE"macOS で Zsh を使っている場合は ~/.zshrc に追加します。Windows では、同じ名前のユーザー環境変数を追加し、新しいターミナルを開きます。Google のセキュリティに関する助言には最初から従う価値があります。キーを Git にコミットしない、ブラウザやモバイルアプリのコードに埋め込まない、本番環境ではシークレットマネージャーを使う、そして Google Cloud コンソールで課金アラートを設定する、といった点です。キーが漏えいした場合、Google はまず代わりのキーを作成してデプロイし、その後に古いキーを無効化して使用状況のログを確認するよう推奨しています。
ステップ3:SDK をインストールする
pip install -U google-genai現在の Google のクイックスタートでは SDK の interactions インターフェースが使われており、以下の例もそれに沿っています。
コード例は Google のドキュメントを基にしたもので、Bullquill では実行していません。最新の SDK リファレンスをご確認ください。
ステップ4:最初のリクエストを送る
次のコードを first_call.py として保存し、python first_call.py で実行します。
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Summarize the trade-offs between batch and real-time inference in five bullet points.",
)
print(interaction.output_text)
print(interaction.usage)
モデルに慣れるまでは、呼び出しのたびに usage を出力する習慣をつけるとよいでしょう。各リクエストが消費した入力・出力・思考トークンの数がわかり、タスクの実際のコストを知るための唯一の確実な方法となります。
ステップ5:思考レベルを選ぶ
Argon は推論モデルです。Google の思考(thinking)に関するドキュメントによると、デフォルトでは「medium」レベルで思考し、low、medium、high を指定できます。レベルは generation_config の中で設定します。
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Extract every date mentioned in this paragraph: ...",
    generation_config={"thinking_level": "low"},
)
ドキュメントにある次の3つのルールを押さえておくと、コストと手間を節約できます。
- 思考トークンは出力として課金されます。API が返すのは推論の要約だけですが、課金対象になります。その数は usage フィールドの思考トークン(thought tokens)の項目に表示されます。
- 思考は
max_output_tokensに含まれます。上限を低く設定すると、モデルが思考の途中で予算を使い切って回答が途切れ、それでも思考分は課金されることがあります。 - タスクに合わせてレベルを選びます。抽出や簡単な整形には low、ほとんどのコーディングやエージェント作業には medium、最も難しい推論には high を使います。
ステップ6:非常に長い出力にはロングデコードを使う
Argon の目玉機能は、完全な証明や大規模なコード移行のような、極めて長い出力を生成できることです。Google のロングデコードガイドによると、これにはバックグラウンド実行が必要です。バックグラウンド実行を使わない場合、max_output_tokens に65,536を超える値を指定すると400エラーが返ります。最小限のパターンは次のとおりです。
import time
from google import genai

client = genai.Client()

job = client.interactions.create(
    model="gemini-4-argon",
    input="Port this module from Python to Rust and explain each change: ...",
    background=True,
    generation_config={"max_output_tokens": 262144, "thinking_level": "high"},
)

while job.status in ("in_progress", "queued"):
    time.sleep(10)
    job = client.interactions.get(id=job.id)

print(job.status)
print(job.usage)
ステータスが completed になったら、job.steps 内のすべての model_output ステップのテキストを結合するよう、ドキュメントは指示しています。長いジョブでは複数のステップが生成されるためです。ガイドにはほかにも次のような説明があります。
- バックグラウンドジョブには保存されたインタラクション(stored interactions)が必要で、最長24時間実行できます。
- ストリーミングを使う場合は、HTTP の読み取りタイムアウトを15〜20分に設定します。約64,000トークンを超えると出力がより大きなまとまりで届くため、長い待ち時間が生じるのは正常です。
- Google は複雑な推論の初期値として262,144を提案しており、8,192のような低い上限は避けるよう警告しています。
- モデルは単語数やトークン数の目標には従わないため、「ちょうど50,000語」のような指示は避けてください。
- ロングデコードは、チャット、要約、抽出、レイテンシーが重要な作業には向いていません。
| ジョブのステータス | 意味 | 対応 |
|---|---|---|
completed | 完了 | すべての model_output ステップを結合する |
requires_action | モデルがツールを呼び出した | ツールを実行し、結果を返す |
incomplete | 出力の予算を使い切った | max_output_tokens を引き上げるか、thinking_level を下げる |
failed | 実行中にエラーが発生した | 再試行する。繰り返す場合はサポートに連絡する |
cancelled | 途中で停止した | usage を確認する。完了した分の処理は課金される |
出典:Google AI for Developers、ロングデコードガイド。
ステップ7:急がない処理はバッチで送る
結果を急がない場合、Batch API を使えば料金は半額になります。Google は24時間以内の処理完了を目標としていますが、多くのジョブはそれより早く終わります。インラインバッチは合計20MB未満のリクエストに適しており、それより大きなジョブには最大2GBの JSONL ファイルを使います。Google の Batch API ドキュメントによると、結果は6週間保持されます。Google のバッチの例では Flash モデルが使われていますが、Argon のモデルページでは Batch がサポート対象として記載されています。
batch = client.batches.create(
    model="gemini-4-argon",
    src=[
        {"contents": [{"role": "user", "parts": [{"text": "Classify this support ticket: ..."}]}]},
        {"contents": [{"role": "user", "parts": [{"text": "Classify this support ticket: ..."}]}]},
    ],
    config={"display_name": "ticket-triage-test"},
)
print(batch.name)
状態が JOB_STATE_SUCCEEDED になるまで client.batches.get(name=batch.name) でポーリングし、その後ジョブの出力先(destination)フィールドからインラインのレスポンスを読み取ります。
ステップ8:コストを管理する
| Argon の料金区分(100万トークンあたり) | 入力(11月30日まで) | 入力(12月1日から) | 出力(11月30日まで) | 出力(12月1日から) |
|---|---|---|---|---|
| Standard | $2.00 | $4.00 | $10.00 | $20.00 |
| Batch / Flex | $1.00 | $2.00 | $5.00 | $10.00 |
| Priority | $3.60 | $7.20 | $18.00 | $36.00 |
| キャッシュ済み入力(Standard) | $0.10 | $0.20 | 該当なし | 該当なし |
出典:Gemini API 料金ページ(2026年10月19日最終更新)。出力料金には思考トークンが含まれます。
- 暗黙的キャッシュを活用します。Argon がサポートするのは暗黙的キャッシュのみで、繰り返される入力が95%割引になります。システム指示や参考資料など、長くて変わらない内容をプロンプトの先頭に置き、変化する部分を末尾に置きましょう。
- 12月以降の料金で予算を組みます。$2と$10の料金でしか採算が合わないワークロードは、6週間後には採算が合わなくなります。
- 規模を拡大する前に測定します。代表的なリクエストを20〜50件実行して使用量を記録し、思考トークンを含めたタスクあたりのコストを算出します。
- 適切な料金区分を使います。夜間ジョブには Batch か Flex、対話的な利用には Standard、Priority はレイテンシーが重要な場合のみ使います。
- 検索グラウンディングに注意します。Google によると、Argon では検索によるグラウンディングのリクエストが月5,000件まで無料で、それを超えると1,000件あたり$14です。
避けるべきよくある失敗
- 無料枠のキーを使う。キーに紐づくプロジェクトで課金が有効になるまで、Argon の呼び出しは失敗します。
- 出力上限を極端に小さく設定する。思考は出力の予算を共有するため、2,000トークンのような上限では、難しいプロンプトに対して回答に回す分が残らないことがあります。
- 何にでもロングデコードを使う。この機能は証明や大規模なコード作業向けです。チャットや要約には通常のリクエストのほうが速く、安く済みます。
- キャンセルしたジョブを放置する。Google は、バックグラウンドジョブがキャンセルまたは失敗する前に完了した処理分を課金するため、実行を中断した場合でも
usageを確認してください。 - 各ホップの入力トークンの合計をコンテキストサイズとみなす。Google は、合計した入力の数値は、長いジョブが実際に使っているコンテキスト量を過大に示すと注意を促しています。
影響と意味
個人の開発者にとっては、導入時の価格が適用されている今こそ、最先端モデルを実際の業務で試すのに最も安い時期です。チームにとってのより大きな教訓は、推論モデルによってコストの見積もり方が変わるということです。目に見える回答は請求額の一部にすぎず、思考レベルや出力上限といった設定はトークン単価と同じくらい重要です。ログ記録と上限設定は、最初の請求書が届いてからではなく、最初の本番デプロイの前に整えておきましょう。
よくある質問
Gemini 4 Argon は無料枠で使えますか?
いいえ。Google の料金ページでは、Gemini 4 Argon は無料枠では利用できないとされています。API で gemini-4-argon を呼び出すには、課金を有効にしたプロジェクトが必要です。
Gemini 4 Argon のモデル ID は何ですか?
Google の開発者向けドキュメントによると、安定版のモデル ID は gemini-4-argon です。
Gemini 4 Argon の思考レベルはどう変更しますか?
generation_config 内の thinking_level を low、medium、high のいずれかに設定します。デフォルトは medium です。思考トークンは出力として課金され、max_output_tokens に含まれます。
65,536トークンを超える出力を得るにはどうすればよいですか?
ロングデコードを使います。background=True と大きめの max_output_tokens を指定してリクエストを送り、完了するまでインタラクションをポーリングします。バックグラウンドモードを使わない場合、65,536を超える値を指定すると400エラーが返ります。
Gemini 4 Argon のコストを抑えるにはどうすればよいですか?
急がない処理には半額の Batch または Flex を使い、プロンプトの先頭部分を固定して暗黙的キャッシュの95%割引を活用し、簡単なタスクには低い思考レベルを選び、2026年12月1日から適用される高い料金を前提に予算を組みます。
出典
- Google AI for Developers: Gemini 4 Argon model page
- Google AI for Developers: Gemini API quickstart
- Google AI for Developers: Using Gemini API keys
- Google AI for Developers: Thinking
- Google AI for Developers: Long decode
- Google AI for Developers: Batch API
- Google AI for Developers: Gemini API pricing
- Google: Gemini 4 Argon is now available in the Gemini app


