AIAITutorial NO. ---
Cómo usar Gemini 4 Argon con la API: guía paso a paso
Desde crear una clave de API hasta ejecutar trabajos en segundo plano de un millón de tokens: así se empieza a usar el nuevo modelo insignia de Google, según su documentación oficial, y así se evita una factura inesperada.

Puntos clave
- Gemini 4 Argon está disponible a través de la API de Gemini con el ID de modelo
gemini-4-argon, solo en el nivel de pago. - Necesita una clave de API de Google AI Studio, el SDK de Python
google-genaiy unos diez minutos para enviar una primera solicitud. - Por defecto, Argon razona en el nivel "medium". Puede configurar
thinking_levelen low, medium o high, y cada token de razonamiento se factura como salida. - Para respuestas muy largas, la "decodificación larga" (long decode) se ejecuta en modo en segundo plano y puede devolver hasta alrededor de 1 millón de tokens de salida; sin ella, la salida se limita a 65.536 tokens.
- Los precios se duplican el 1 de diciembre de 2026. Los trabajos por lotes cuestan la mitad y los prefijos de prompt repetidos reciben un descuento de caché del 95 %, así que conviene diseñar para ambos desde el primer día.
El nuevo modelo insignia de Google lleva poco más de una semana en manos de los desarrolladores, y en los foros se repiten siempre las mismas preguntas: ¿cómo obtengo acceso?, ¿qué ajustes importan? y ¿cómo evito una factura inesperada? Esta guía recorre paso a paso la configuración oficial y toma como referencia la propia documentación de Google. Se asume una familiaridad básica con Python y con la terminal. Todos los precios están en dólares estadounidenses y provienen de la página de precios de Google al 19 de octubre de 2026.
Antes de empezar: qué necesita
- Una cuenta de Google y acceso a Google AI Studio.
- Un proyecto de Google Cloud con la facturación habilitada. La página de precios de Google indica que Argon "no está disponible" en el nivel gratuito, por lo que las claves de ese nivel no funcionarán con este modelo.
- Python 3 y
pipinstalados en su equipo. - Un presupuesto aproximado. Incluso los experimentos pequeños con un modelo de razonamiento pueden consumir más tokens de lo que espera.
Paso 1: Cree una clave de API
La documentación de claves de API de Google describe el proceso en AI Studio:
- Abra la página de claves de API (API keys) en Google AI Studio.
- Si ya tiene un proyecto de Google Cloud, AI Studio no lo muestra por defecto. Vaya al Dashboard, elija Projects, luego Import projects, seleccione su proyecto e impórtelo.
- En la página API Keys, haga clic en Create API key. Si el botón no está disponible, su cuenta no tiene los permisos necesarios en ese proyecto; pida a un administrador un rol como Project Editor.
- Use la opción "Add restrictions" para limitar la clave a la API de Gemini.
Paso 2: Guarde la clave de forma segura
El SDK lee la clave de una variable de entorno llamada GEMINI_API_KEY (o GOOGLE_API_KEY, que tiene prioridad si ambas están definidas). En Linux o macOS con Bash, agregue esta línea a ~/.bashrc y recargue la shell:
export GEMINI_API_KEY="YOUR_API_KEY_HERE"En macOS con Zsh, use ~/.zshrc. En Windows, agregue una variable de entorno de usuario con el mismo nombre y abra una nueva terminal. Vale la pena seguir los consejos de seguridad de Google desde el inicio: nunca suba claves a Git, nunca las incruste en código de navegador o de aplicaciones móviles, use un gestor de secretos en producción y configure alertas de facturación en la consola de Google Cloud. Si una clave se filtra, Google recomienda crear e implementar primero una clave de reemplazo, luego desactivar la antigua y revisar los registros de uso.
Paso 3: Instale el SDK
pip install -U google-genaiLa guía de inicio rápido actual de Google usa la interfaz interactions del SDK, que es la que siguen los ejemplos de abajo.
Los ejemplos de código están adaptados de la documentación de Google y Bullquill no los ha ejecutado; consulte la referencia actual del SDK.
Paso 4: Envíe su primera solicitud
Guarde lo siguiente como first_call.py y ejecútelo con python first_call.py:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Summarize the trade-offs between batch and real-time inference in five bullet points.",
)
print(interaction.output_text)
print(interaction.usage)
Imprimir usage en cada llamada es un buen hábito mientras aprende a usar el modelo. Muestra cuántos tokens de entrada, de salida y de razonamiento consumió cada solicitud, y es la única forma fiable de saber cuánto cuesta realmente una tarea.
Paso 5: Elija un nivel de razonamiento
Argon es un modelo de razonamiento. Según la documentación de Google sobre razonamiento (thinking), por defecto razona en el nivel "medium" y acepta low, medium o high. El nivel se configura dentro de generation_config:
interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Extract every date mentioned in this paragraph: ...",
    generation_config={"thinking_level": "low"},
)
Tres reglas de la documentación ahorran dinero y frustraciones:
- Los tokens de razonamiento se facturan como salida, aunque la API solo devuelva un resumen del razonamiento. La cifra aparece en el campo usage correspondiente a los tokens de pensamiento (thought tokens).
- El razonamiento cuenta para
max_output_tokens. Si fija un límite bajo, el modelo puede quedarse sin presupuesto a mitad del razonamiento, cortar la respuesta y aun así cobrarle el razonamiento. - Ajuste el nivel a la tarea. Use low para extracción y formato sencillo, medium para la mayor parte del trabajo de programación y de agentes, y high para el razonamiento más difícil.
Paso 6: Use la decodificación larga para salidas muy extensas
La función estrella de Argon es su capacidad de producir salidas extremadamente largas, como una demostración completa o una gran migración de código. La guía de decodificación larga de Google indica que esto requiere ejecución en segundo plano. Sin ella, cualquier valor de max_output_tokens superior a 65.536 devuelve un error 400. Un patrón mínimo es el siguiente:
import time
from google import genai

client = genai.Client()

job = client.interactions.create(
    model="gemini-4-argon",
    input="Port this module from Python to Rust and explain each change: ...",
    background=True,
    generation_config={"max_output_tokens": 262144, "thinking_level": "high"},
)

while job.status in ("in_progress", "queued"):
    time.sleep(10)
    job = client.interactions.get(id=job.id)

print(job.status)
print(job.usage)
Cuando el estado sea completed, la documentación indica que hay que unir el texto de cada paso model_output en job.steps, porque un trabajo largo produce varios. Otros detalles de la guía:
- Los trabajos en segundo plano requieren interacciones almacenadas y pueden ejecutarse hasta 24 horas.
- Si usa streaming, configure tiempos de espera de lectura HTTP de 15 a 20 minutos. A partir de unos 64.000 tokens, la salida llega en fragmentos más grandes, así que las pausas largas son normales.
- Google sugiere 262.144 como valor inicial para razonamiento complejo y desaconseja límites bajos como 8.192.
- El modelo no respeta objetivos de palabras ni de tokens, así que no pida "exactamente 50.000 palabras".
- La decodificación larga no es adecuada para chat, resúmenes, extracción ni trabajo sensible a la latencia.
| Estado del trabajo | Qué significa | Qué hacer |
|---|---|---|
completed | Terminado | Unir todos los pasos model_output |
requires_action | El modelo llamó a una herramienta | Ejecutar la herramienta y devolver el resultado |
incomplete | Se agotó el presupuesto de salida | Aumentar max_output_tokens o bajar thinking_level |
failed | Error durante la ejecución | Reintentar; contactar a soporte si se repite |
cancelled | Detenido antes de tiempo | Revisar usage: el trabajo completado se factura igualmente |
Fuente: Google AI for Developers, guía de decodificación larga.
Paso 7: Envíe el trabajo no urgente por lotes
Si los resultados pueden esperar, la Batch API reduce el precio a la mitad. Google apunta a un plazo de entrega de 24 horas, aunque muchos trabajos terminan antes. Los lotes en línea (inline) sirven para solicitudes de menos de 20 MB en total; los trabajos más grandes usan un archivo JSONL de hasta 2 GB. La documentación de la Batch API de Google indica que los resultados permanecen disponibles durante seis semanas. El ejemplo de lotes de Google usa un modelo Flash, pero la página del modelo Argon indica que Batch es compatible:
batch = client.batches.create(
    model="gemini-4-argon",
    src=[
        {"contents": [{"role": "user", "parts": [{"text": "Classify this support ticket: ..."}]}]},
        {"contents": [{"role": "user", "parts": [{"text": "Classify this support ticket: ..."}]}]},
    ],
    config={"display_name": "ticket-triage-test"},
)
print(batch.name)
Consulte periódicamente con client.batches.get(name=batch.name) hasta que el estado sea JOB_STATE_SUCCEEDED y luego lea las respuestas en línea del campo de destino del trabajo.
Paso 8: Mantenga los costos bajo control
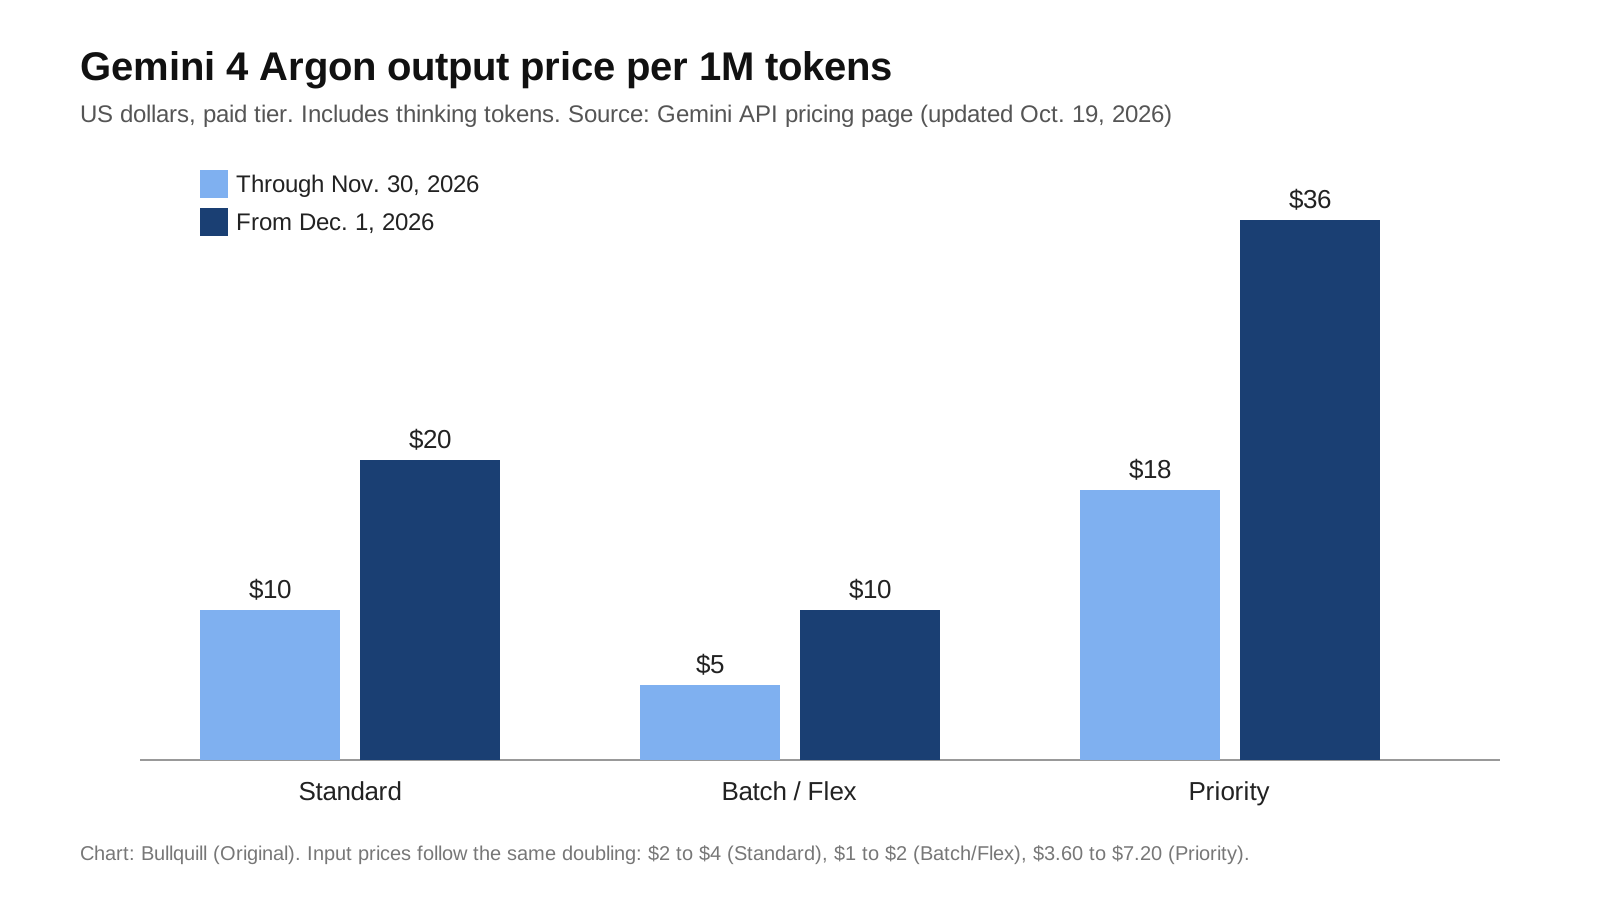
| Nivel de Argon (por 1 M de tokens) | Entrada, hasta el 30 nov. | Entrada, desde el 1 dic. | Salida, hasta el 30 nov. | Salida, desde el 1 dic. |
|---|---|---|---|---|
| Standard | $2.00 | $4.00 | $10.00 | $20.00 |
| Batch / Flex | $1.00 | $2.00 | $5.00 | $10.00 |
| Priority | $3.60 | $7.20 | $18.00 | $36.00 |
| Entrada en caché (Standard) | $0.10 | $0.20 | n/d | n/d |
Fuente: página de precios de la API de Gemini, última actualización el 19 de oct. de 2026. Los precios de salida incluyen los tokens de razonamiento.
- Aproveche la caché implícita. Argon solo admite caché implícita, que descuenta un 95 % la entrada repetida. Coloque el contenido largo y estable, como las instrucciones del sistema y los documentos de referencia, al inicio del prompt, y la parte variable al final.
- Presupueste con los precios de diciembre. Si una carga de trabajo solo tiene sentido a $2 y $10, dejará de tenerlo en seis semanas.
- Mida antes de escalar. Ejecute entre 20 y 50 solicitudes representativas, registre el uso y calcule el costo por tarea, incluidos los tokens de razonamiento.
- Use el nivel adecuado. Batch o Flex para trabajos nocturnos; Standard para uso interactivo; Priority solo cuando la latencia importe.
- Vigile el grounding con búsqueda. Google indica 5.000 solicitudes de búsqueda con grounding gratuitas al mes en Argon y, después, $14 por cada 1.000.
Errores comunes que conviene evitar
- Usar una clave del nivel gratuito. Las llamadas a Argon fallarán hasta que se habilite la facturación en el proyecto asociado a la clave.
- Fijar un límite de salida minúsculo. Como el razonamiento comparte el presupuesto de salida, un límite como 2.000 tokens puede no dejar nada para la respuesta ante un prompt difícil.
- Activar la decodificación larga para todo. Está pensada para demostraciones y grandes tareas de código. Para chat o resúmenes, una solicitud normal es más rápida y barata.
- Ignorar los trabajos cancelados. Google factura el trabajo completado antes de que un trabajo en segundo plano se cancele o falle, así que revise
usageincluso cuando abandone una ejecución. - Tomar el total de tokens de entrada de todos los saltos como tamaño del contexto. Google advierte que la cifra de entrada sumada sobrestima cuánto contexto está usando realmente un trabajo largo.
Qué significa
Para los desarrolladores individuales, el precio de lanzamiento hace de este el momento más barato para evaluar un modelo de frontera con trabajo real. Para los equipos, la lección más importante es que los modelos de razonamiento cambian la forma de calcular costos: la respuesta visible es solo una parte de la factura, y ajustes como el nivel de razonamiento y los límites de salida importan tanto como el precio por token. Prepare el registro de uso y los límites antes de su primer despliegue en producción, no después de su primera factura.
Preguntas frecuentes
¿Puedo usar Gemini 4 Argon en el nivel gratuito?
No. La página de precios de Google indica que Gemini 4 Argon no está disponible en el nivel gratuito. Necesita un proyecto con la facturación habilitada para llamar a gemini-4-argon a través de la API.
¿Cuál es el ID de modelo de Gemini 4 Argon?
El ID de modelo estable es gemini-4-argon, según la documentación para desarrolladores de Google.
¿Cómo cambio el nivel de razonamiento de Gemini 4 Argon?
Configure thinking_level dentro de generation_config en low, medium o high. El valor predeterminado es medium. Los tokens de razonamiento se facturan como salida y cuentan para max_output_tokens.
¿Cómo obtengo salidas de más de 65.536 tokens?
Use la decodificación larga (long decode): envíe la solicitud con background=True y un max_output_tokens más alto, y consulte la interacción hasta que termine. Sin el modo en segundo plano, los valores superiores a 65.536 devuelven un error 400.
¿Cómo puedo reducir los costos de Gemini 4 Argon?
Use los niveles Batch o Flex para el trabajo no urgente a mitad de precio, mantenga un prefijo de prompt estable para aprovechar el descuento del 95 % de la caché implícita, elija niveles de razonamiento más bajos para tareas sencillas y presupueste con los precios más altos que se aplican desde el 1 de diciembre de 2026.
Fuentes
- Google AI for Developers: Gemini 4 Argon model page
- Google AI for Developers: Gemini API quickstart
- Google AI for Developers: Using Gemini API keys
- Google AI for Developers: Thinking
- Google AI for Developers: Long decode
- Google AI for Developers: Batch API
- Google AI for Developers: Gemini API pricing
- Google: Gemini 4 Argon is now available in the Gemini app


