AIAIExplainer NO. ---
Gemini 4 Argon frente a GPT-6 Astra y Claude Opus 5.5: las cifras
El nuevo modelo insignia de Google encabeza la mayoría de las filas de su propia tabla de benchmarks y es más barato que sus rivales hasta el 30 de noviembre. Esto dicen las cifras oficiales, dónde discrepan los proveedores y cuánto cuesta en la práctica.

Puntos clave
- Google anunció Gemini 4 Argon el 30 de septiembre de 2026 y lo abrió a los suscriptores de Google AI Pro y Ultra y a los clientes de pago de la API el 13 de octubre. El ID del modelo en la API es
gemini-4-argon. - En la tabla comparativa de la propia Google, Argon obtiene la puntuación más alta en la mayoría de las filas frente a GPT-6 Astra de OpenAI y Claude Opus 5.5 y Fable 5.1 de Anthropic, pero queda por detrás en Terminal-bench 4.0, FrontierSWE v2, Terminal-Bench Science, PostTrainBench y OSWorld-2.0.
- El precio es el arma más afilada. Argon cuesta 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida hasta el 30 de noviembre de 2026; después, 4 y 20 dólares. GPT-6 Astra tiene un precio de lista de 10 y 50 dólares; Opus 5.5, de 4 y 20 dólares.
- Argon tiene una ventana de contexto de 1.048.576 tokens compartida entre entrada y salida, y un modo de "decodificación larga" (long decode) que puede producir hasta aproximadamente 1 millón de tokens de salida en una sola tarea en segundo plano.
- Todas las cifras de benchmarks principales aquí son autodeclaradas por las empresas, y las tablas de los proveedores no coinciden entre sí para los mismos modelos. Conviene tomarlas como orientativas.
Tres semanas después de que Google lo presentara, y una semana después de que llegara a los usuarios de pago, Gemini 4 Argon es el modelo de IA con el que se mide el resto del sector. Llega en un otoño muy concurrido: OpenAI lanzó GPT-6 Astra a principios de septiembre y Anthropic publicó Claude Opus 5.5 el 22 de septiembre. Cada empresa reivindica el liderazgo en algún conjunto de pruebas. Este artículo pone las cifras oficiales una al lado de la otra, explica dónde se contradicen y analiza qué significan los precios en la práctica.
Qué lanzó Google y cuándo
El anuncio de Google DeepMind, publicado el 30 de septiembre con la firma de Koray Kavukcuoglu, su arquitecto jefe de IA, describía un despliegue por fases. Argon llegó primero a un grupo verificado de defensores de ciberseguridad a través de lo que Google llama Fairwind Program, y la empresa dijo que esa versión se entregó sin sus salvaguardas de ciberseguridad habituales a esos usuarios de confianza y a equipos internos. Google también afirmó que participaba en el proceso voluntario de acceso previo al lanzamiento del Gobierno de Estados Unidos. En palabras de la compañía, "Safely releasing frontier capabilities at this level requires a phased approach" (lanzar de forma segura capacidades de vanguardia de este nivel requiere un enfoque por fases).
El acceso amplio llegó el 13 de octubre. El blog de productos de Google indicó que los suscriptores Pro y Ultra podían usar Argon en la aplicación Gemini, junto con una nueva función, Tasks, que permite a Gemini seguir trabajando en distintas aplicaciones conectadas, y una interfaz de programación agéntica de Google Antigravity dentro de la aplicación Gemini para macOS. Los desarrolladores pueden usarlo a través de la API de Gemini y Google AI Studio en el nivel de pago; la página de precios de Google indica que Argon no está disponible en el nivel gratuito.
La publicación de lanzamiento de Google se apoyó tanto en demostraciones prácticas como en puntuaciones. Según la empresa, una versión en Rust del decodificador de video libgav1, reescrita por agentes de Argon, decodifica video 2,7 veces más rápido que la versión original, y agentes de Argon que trabajaron en un proyecto interno de eficiencia de memoria identificaron optimizaciones que se espera liberen más de 300 TiB. Son resultados internos de Google y no se han reproducido de forma independiente.
Las especificaciones, frente a frente
| Elemento | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Lanzamiento | Anunciado el 30 sept.; acceso amplio el 13 oct. de 2026 | Principios de septiembre de 2026 | 22 sept. 2026 |
| Precio de entrada (por 1M de tokens) | 2,00 $ hasta el 30 nov., luego 4,00 $ | 10,00 $ | 4,00 $ |
| Precio de salida (por 1M de tokens) | 10,00 $ hasta el 30 nov., luego 20,00 $ | 50,00 $ | 20,00 $ |
| Entrada en caché (por 1M de tokens) | 0,10 $, luego 0,20 $ (solo caché implícita) | 1,00 $ | 0,20 $ (lectura de caché); 5 $ escritura de caché |
| Ventana de contexto | 1.048.576 tokens, compartida con la salida | 1.050.000 tokens | No se indica por modelo en la página de precios ("hasta 1M") |
| Salida máxima | 65.536 por defecto; hasta 1.048.576 con long decode | 128.000 tokens | No se indica en las fuentes consultadas |
| Fecha de corte de conocimiento | No se indica | 30 de abril de 2026 | No se indica en las fuentes consultadas |
| Entradas | Texto, imagen, video, audio, PDF | Ver documentación de OpenAI | Ver documentación de Anthropic |
Fuentes: páginas de modelo y de precios de Google AI for Developers (última actualización 14 y 19 de octubre de 2026); documentación para desarrolladores de OpenAI sobre GPT-6 Astra; anuncio de Opus 5.5 de Anthropic y página de precios de Claude. Precios del nivel estándar, en dólares estadounidenses.
Hay dos detalles fáciles de pasar por alto. Primero, el "contexto de 1M" de Argon es un único presupuesto compartido entre entrada y salida, de modo que una instrucción muy larga deja menos espacio para la respuesta. Segundo, el precio de lanzamiento de Google es temporal: desde el 1 de diciembre, Argon cuesta lo mismo por token que Opus 5.5. El procesamiento Batch y Flex de Argon cuesta la mitad de la tarifa estándar, y Priority cuesta más.
La tabla de benchmarks y sus salvedades
La página del modelo de Google compara Argon con GPT-6 Astra, Claude Fable 5.1 y Claude Opus 5.5 en 19 filas agrupadas en ocho áreas: trabajo del conocimiento, programación agéntica, ingeniería de aprendizaje automático, ciencia y matemáticas, contexto largo, uso de computadoras, comprensión multimodal y ciberseguridad. La selección de abajo abarca la mayoría de esas áreas. Todas las cifras son de Google.
| Benchmark (tabla de Google) | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index (trabajo del conocimiento) | 68,9 % | 63,1 % | 65,8 % | 67,0 % |
| AutomationBench | 51,3 % | 41,4 % | 31,4 % | 42,5 % |
| DeepSWE v1.1 (programación agéntica) | 77,9 % | 74,1 % | 67,4 % | 74,2 % |
| FrontierSWE v2 | 55,0 % | 65,5 % | 56,3 % | 62,3 % |
| Terminal-bench 4.0 | 57,4 % | 58,2 % | 57,9 % | 66,4 % |
| Terminal-Bench Science 0.1 | 57,6 % | 68,1 % | 52,6 % | 63,3 % |
| GraphWalks BFS, de 256k a 1M (F1) | 84,2 % | 71,8 % | 65,0 % | 66,8 % |
| LVBench (comprensión de video) | 91,7 % | 87,5 % | 79,7 % | 83,7 % |
| Agent's Last Exam (uso de computadoras) | 39,5 % | 34,2 % | n/d | 38,2 % |
| CWE-bench v1 (ciberseguridad) | 68,0 % | 68,0 % | 58,0 % | 67,0 % |
Fuente: Google DeepMind, página del modelo Gemini, resultados autodeclarados. La negrita marca la puntuación más alta de cada fila.
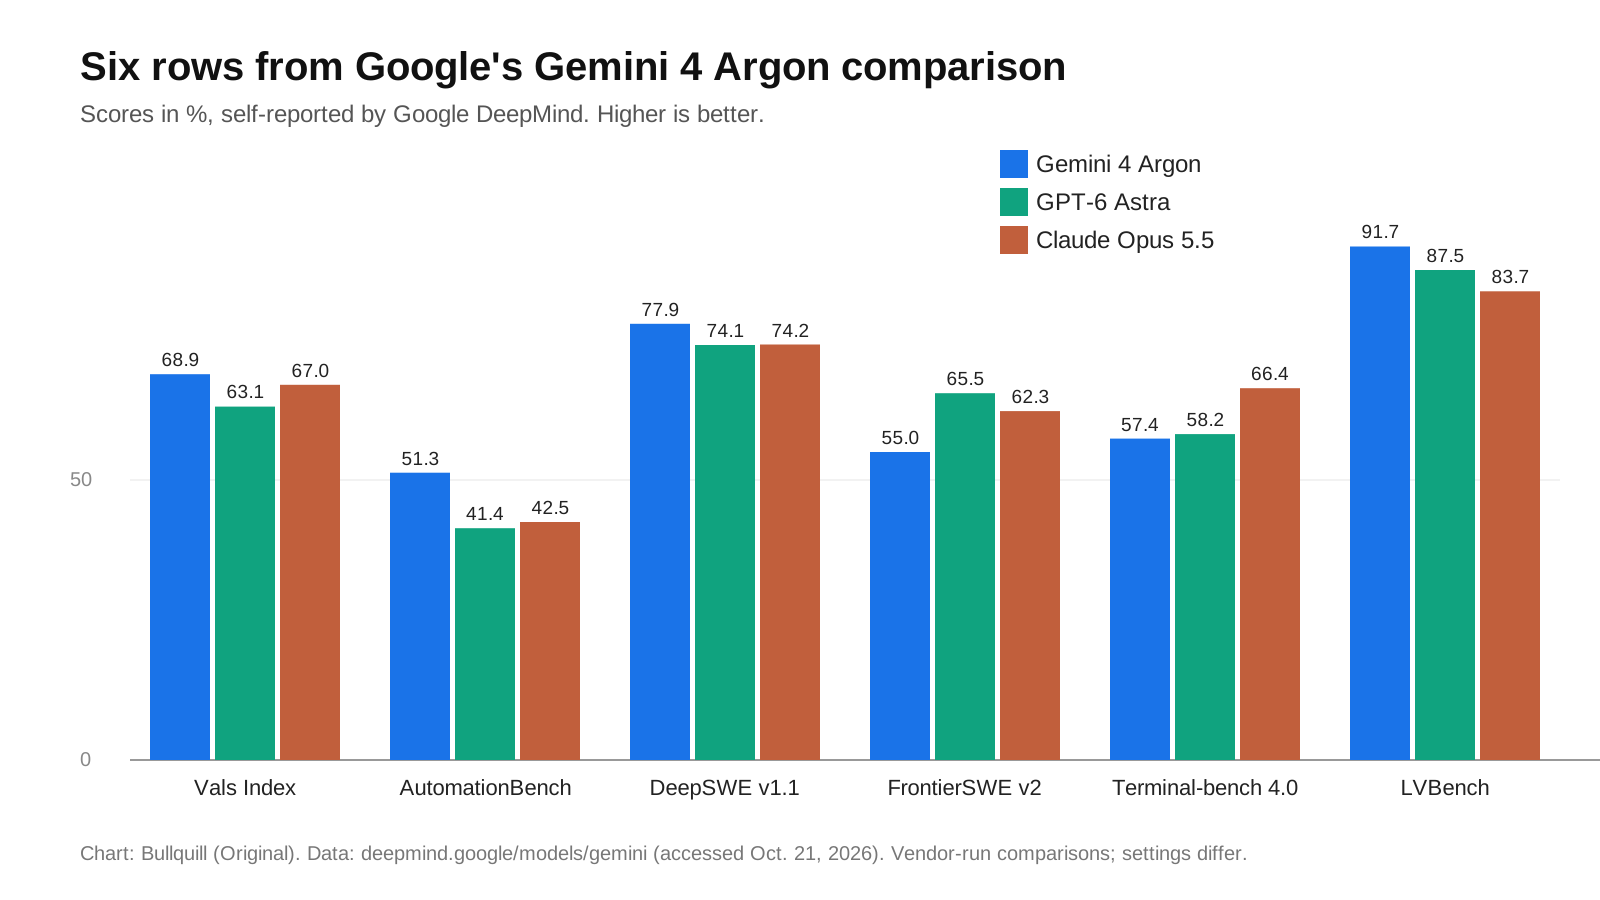
El patrón es bastante claro: Argon es más fuerte en la automatización del trabajo del conocimiento, la recuperación de información en contextos largos y la comprensión de video, y es competitivo, aunque no dominante, en programación agéntica. Opus 5.5 de Anthropic lidera en Terminal-bench 4.0, y Astra de OpenAI lidera en FrontierSWE v2 y en la prueba de terminal científica. La mayor diferencia individual está en la recuperación en contextos largos de entre 256.000 y 1 millón de tokens, donde el 84,2 % de Argon supera en más de 12 puntos al siguiente modelo de la tabla de Google.
La pregunta más difícil es cuánto confiar en una sola tabla. Cuando las empresas prueban por su cuenta los modelos rivales, eligen la configuración, el acceso a herramientas y el nivel de esfuerzo. Así, un mismo benchmark puede arrojar cifras distintas para el mismo modelo según quién lo ejecute:
| Modelo y benchmark | Tabla de Google | Anuncio de Anthropic |
|---|---|---|
| Opus 5.5 en AutomationBench | 42,5 % | 40,0 % |
| Opus 5.5 en Terminal-Bench Science 0.1 | 63,3 % | 58,7 % |
| GPT-6 Astra en Terminal-Bench Science 0.1 | 68,1 % | 64,6 % |
| GPT-6 Astra en Terminal-bench 4.0 | 58,2 % | 57,9 % |
La propia Anthropic señala que algunas de sus puntuaciones se obtuvieron con distintos niveles de esfuerzo. Las clasificaciones independientes ayudan, pero no zanjan la cuestión. Vals.ai, que gestiona el Vals Index, situó a Argon con un 68,90 % y en el primer puesto de 41 modelos en una actualización del 30 de septiembre, mientras que su página del modelo mostró más tarde una puntuación y una posición ligeramente distintas, un ejemplo de lo rápido que cambian estas clasificaciones a medida que se actualizan los modelos y los conjuntos de pruebas. Vals también informó de que Argon costó menos por prueba que Opus 5.5 en su índice.
Qué suponen los precios en la práctica
Los precios por token se comparan mejor con un ejemplo. Tomemos una solicitud con 100.000 tokens de entrada y 10.000 tokens de salida, típica de la revisión de un documento extenso, sin tener en cuenta la caché:
| Modelo | Costo de entrada | Costo de salida | Total por solicitud |
|---|---|---|---|
| Gemini 4 Argon (hasta el 30 nov.) | 0,20 $ | 0,10 $ | 0,30 $ |
| Gemini 4 Argon (desde el 1 dic.) | 0,40 $ | 0,20 $ | 0,60 $ |
| Claude Opus 5.5 | 0,40 $ | 0,20 $ | 0,60 $ |
| GPT-6 Astra | 1,00 $ | 0,50 $ | 1,50 $ |
Cálculo de Bullquill a partir de los precios de lista. Las facturas reales dependen de la caché, los descuentos por lotes y, sobre todo, de los tokens de razonamiento.
Este último punto es importante. La documentación de Google indica que los tokens de razonamiento (thinking) de Argon se facturan como salida, aunque la API solo devuelve un resumen del razonamiento, y que el nivel de razonamiento predeterminado es "medium". Por tanto, un problema difícil puede generar mucha más salida facturable de lo que sugiere la respuesta visible. La misma lógica se aplica, de distintas maneras, a los demás modelos de razonamiento: el anuncio de Opus 5.5 de Anthropic indica que en ese modelo ya no se puede desactivar el razonamiento.
Otras novedades de la semana
Google no fue el único laboratorio en lanzar productos. DeepSeek publicó una actualización menor, DeepSeek-V4.1-Flash-1017, en Hugging Face con licencia MIT, con un contexto de 1 millón de tokens y mejoras en benchmarks respecto de la versión Flash anterior, y presentó un framework de inferencia de código abierto llamado DeepInfer que atrajo mucha atención en Hacker News. En la tabla publicada por la propia DeepSeek, el modelo de pesos abiertos todavía queda por detrás del anterior Opus 5 de Anthropic en pruebas como Humanity's Last Exam sin herramientas, pero lo supera por poco en DeepSWE v1.1, señal de que la brecha en programación agéntica se está reduciendo.
Qué significa
Para los desarrolladores. Argon es el más barato de los tres modelos insignia hasta el 30 de noviembre. Los equipos que quieran probarlo al precio más bajo tienen unas seis semanas. Quien construya sobre él debería presupuestar con el precio de diciembre y fijar los niveles de razonamiento de forma deliberada.
Para las empresas. Las especificaciones están convergiendo: los tres modelos ofrecen ya ventanas de contexto de alrededor de 1 millón de tokens y precios en un rango similar, salvo el sobreprecio de Astra. La decisión depende cada vez más de qué modelo rinde mejor con su propia carga de trabajo, y del tratamiento de los datos y la disponibilidad regional, más que de las puntuaciones destacadas.
Para el mercado. El precio de lanzamiento de Google presiona el precio de lista más alto de OpenAI. Según el anuncio de Opus 5.5 de Anthropic, la empresa rebajó el precio de Opus con la versión 5.5, de 5 y 25 dólares a 4 y 20 dólares. La tendencia apunta a precios más bajos para un mismo nivel de capacidad.
Para la política de seguridad. El lanzamiento escalonado de Google, con una versión sin salvaguardas para defensores de ciberseguridad verificados y la participación en un proceso de acceso previo del Gobierno de Estados Unidos, muestra cómo gestionan ahora los laboratorios los modelos más capaces: primero acceso limitado, después lanzamiento amplio.
Preguntas frecuentes
¿Cuándo se lanzó Gemini 4 Argon?
Google lo anunció el 30 de septiembre de 2026, inicialmente para defensores de ciberseguridad verificados. El acceso amplio para suscriptores de Google AI Pro y Ultra y para clientes de pago de la API comenzó el 13 de octubre de 2026.
¿Cuánto cuesta la API de Gemini 4 Argon?
En el nivel de pago estándar, 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida hasta el 30 de noviembre de 2026; después, 4 y 20 dólares a partir del 1 de diciembre. La entrada en caché cuesta 0,10 dólares y sube a 0,20. Batch y Flex cuestan la mitad. No está disponible en el nivel gratuito.
¿Cuál es la ventana de contexto de Gemini 4 Argon?
1.048.576 tokens, compartidos entre entrada y salida. La salida predeterminada está limitada a 65.536 tokens; la decodificación larga (long decode) en modo en segundo plano permite hasta aproximadamente 1 millón de tokens de salida.
¿Es Gemini 4 Argon mejor que GPT-6 Astra y Claude Opus 5.5?
En la tabla de la propia Google lidera la mayoría de las filas, pero GPT-6 Astra encabeza FrontierSWE v2 y Terminal-Bench Science, y Opus 5.5 encabeza Terminal-bench 4.0. Los resultados que publica cada proveedor difieren para los mismos modelos, así que conviene probarlo con su propia carga de trabajo.
¿Se facturan los tokens de razonamiento?
Sí. La documentación de Google indica que los tokens de razonamiento (thinking) de Argon se facturan como tokens de salida, aunque la API solo devuelve un resumen del razonamiento.
Fuentes
- Google: Gemini 4 Argon, our next era of frontier intelligence (30 sept. 2026)
- Google: Gemini 4 Argon is now available in the Gemini app (13 oct. 2026)
- Google DeepMind: página del modelo Gemini y tabla de benchmarks
- Google AI for Developers: página del modelo Gemini 4 Argon
- Google AI for Developers: precios de la API de Gemini
- Documentación para desarrolladores de OpenAI: GPT-6 Astra
- Anthropic: anuncio de Claude Opus 5.5
- Anthropic: precios de Claude
- Vals.ai: resultados de Gemini 4 Argon
- Hugging Face: ficha del modelo DeepSeek-V4.1-Flash-1017


